Fireworks Ember-1: O modelo de raciocínio baseado no Kimi K3
O Fireworks Ember-1 é um modelo de raciocínio construído sobre o Kimi K3, com cerca de 40% menos tokens. Veja como ele funciona e por que isso reduz o custo de IA.
O Fireworks Ember-1 apareceu em setembro de 2026 com uma promessa específica: entregar a qualidade do Kimi K3 gastando cerca de 40% menos tokens no raciocínio. Para quem usa modelos de IA em produção, isso não é um detalhe técnico, é uma redução direta de custo. E o jeito como o modelo foi construído diz bastante sobre para onde a indústria de IA está indo.
Se você já ouviu falar do Kimi K3 e quer entender o que o Ember-1 muda, ou se simplesmente quer saber por que "40% menos tokens" importa, este guia explica em linguagem simples o que é o modelo, como ele funciona e onde ele encaixa no seu dia a dia.
O que é Fireworks Ember-1
O Ember-1 é um modelo de linguagem criado pela Fireworks Research, divisão de pesquisa da Fireworks AI. Ele não é um modelo base novo, e essa distinção é importante: o Ember-1 foi construído a partir do Kimi K3, da Moonshot AI, e treinado para pensar de forma mais econômica.
Em outras palavras, a Fireworks pegou um modelo de raciocínio já forte e o especializou para gastar menos. Não se trata de um modelo menor ou de uma versão simplificada, e sim de uma versão treinada para chegar à mesma resposta com menos esforço interno.
O lançamento aconteceu em 23 de setembro de 2026, e é o primeiro modelo da série da Fireworks Research. A empresa já sinalizou que virão outros, todos seguindo a mesma ideia de modelos especializados, ajustados para tarefas específicas em vez de tentar cobrir tudo.
Por que o modelo de raciocínio gasta tantos tokens
Para entender o valor do Ember-1, é preciso entender o problema que ele resolve. Modelos de raciocínio, como o Kimi K3, gastam a maior parte dos tokens gerados pensando antes de responder. Em alguns casos, mais de 90% do que o modelo produz é raciocínio interno, não a resposta final.
Isso é caro em uma única chamada e muito pior em fluxos com várias etapas. Em trabalhos agênticos, onde o modelo precisa executar tarefas em sequência, cada turno reenvia todo o raciocínio anterior de volta ao modelo. O contexto cresce de forma quase quadrática com o número de turnos, e o raciocínio longo dos primeiros passos é relido e cobrado de novo em cada chamada seguinte.
Imagine pagar para reler um rascunho a cada vez que alguém revisa um documento. É mais ou menos isso. O raciocínio bruto do Kimi K3 é muito mais longo do que a tarefa exige, e esse excesso pode ser cortado sem prejudicar a resposta. Foi exatamente essa a aposta do Ember-1.
Como a Fireworks construiu o Ember-1
A construção do Ember-1 não foi um ajuste simples, foi um trabalho de treinamento. A equipe percebeu que reduzir o esforço de raciocínio nas configurações do Kimi K3 não resolvia, porque o modelo perdia qualidade demais. Para cortar tokens mantendo a qualidade, o modelo precisava aprender a raciocinar de forma mais eficiente.
Segundo a Fireworks, o processo envolveu mais de 50 experimentos de treinamento e mais de 200 avaliações. A equipe também desenvolveu algoritmos de treinamento novos para encurtar o raciocínio sem perder precisão. Todo o trabalho rodou na plataforma de treinamento serverless da própria Fireworks, o que permitiu lançar experimentos rápidos e pagar apenas pelo que rodava.
O treinamento usou uma variedade ampla de tarefas, para que a economia de tokens se aplicasse a muitos tipos de trabalho, e a Fireworks afirma que usou apenas dados próprios, sem dados de clientes. O resultado foi validado em benchmarks externos, em testes A/B com clientes reais e nas próprias cargas de trabalho de codificação da empresa.
O que significa 40% menos tokens na prática
A redução de tokens de raciocínio tem um efeito direto no bolso de quem usa IA em produção. Menos tokens significam menos custo por chamada e mais chamadas possíveis dentro de um mesmo orçamento.
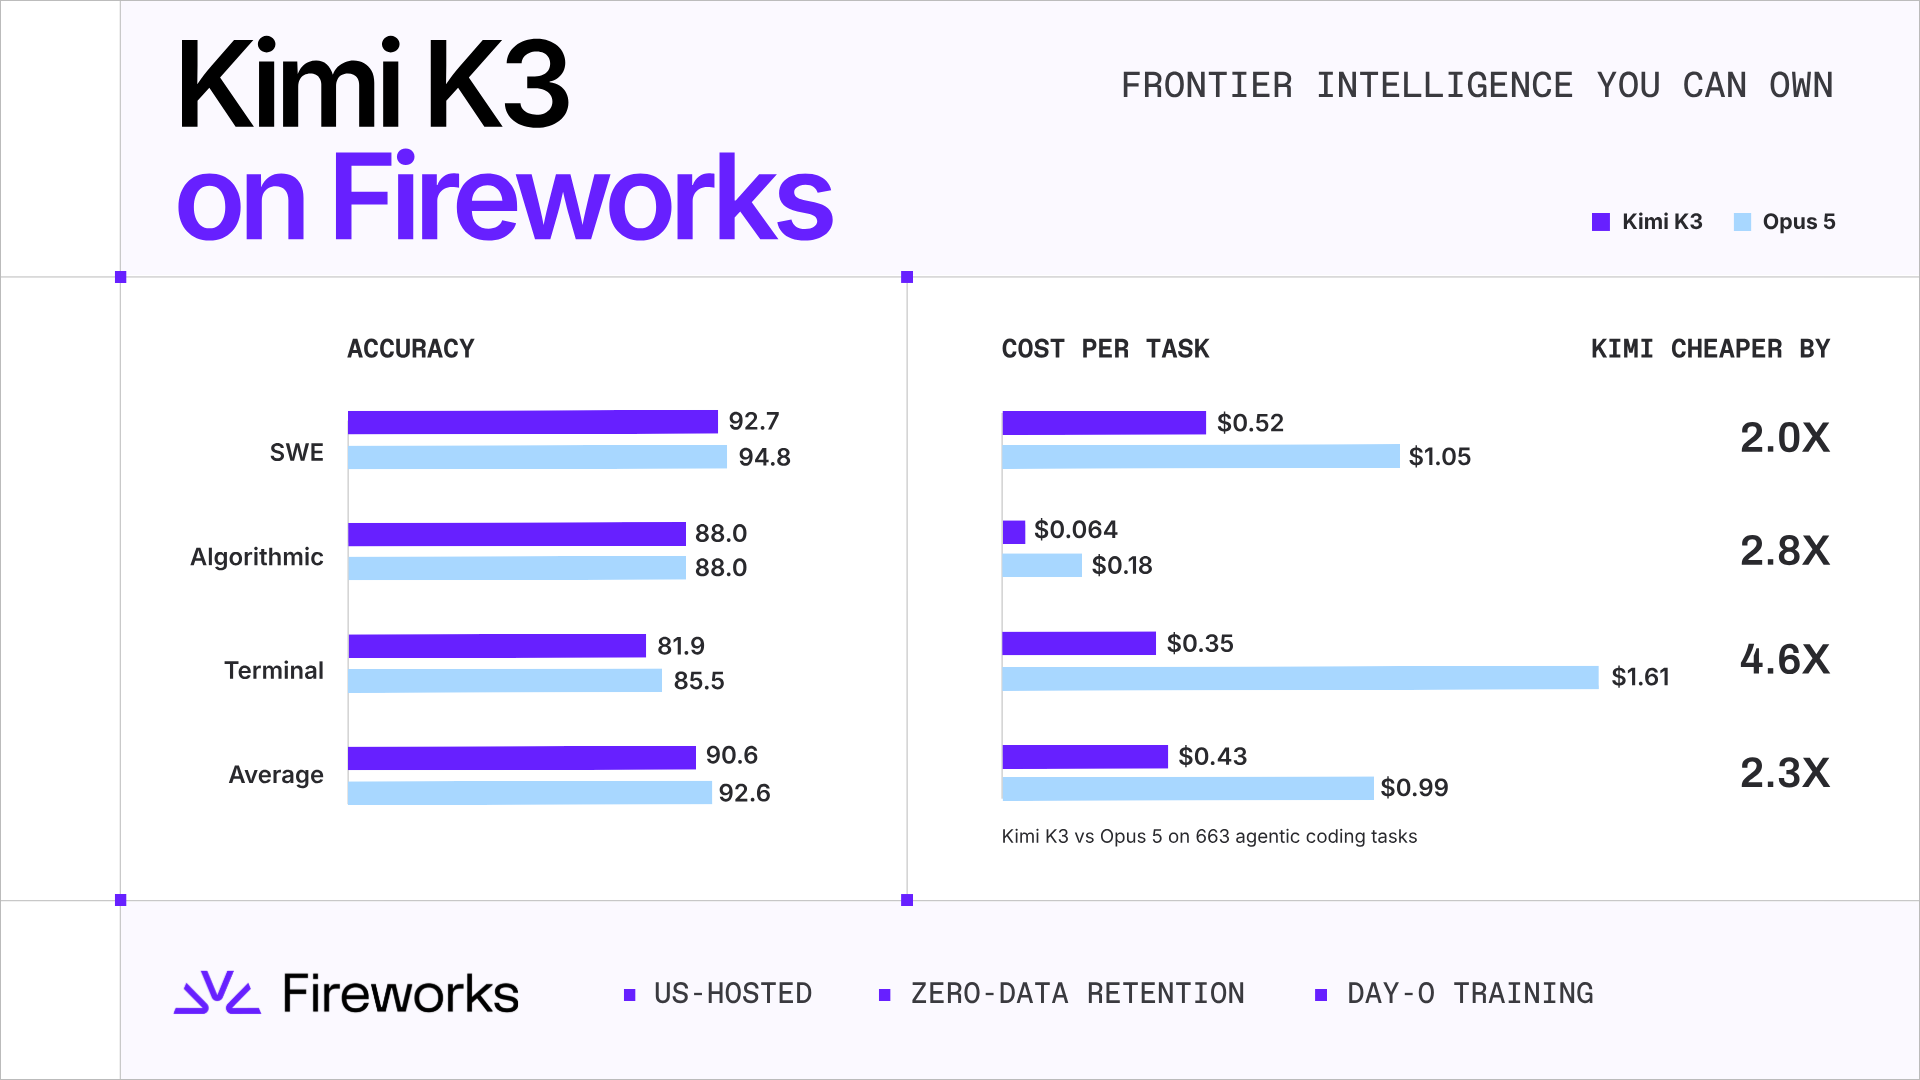
Em testes internos da Fireworks, os desenvolvedores da própria empresa não notaram diferença de qualidade ao usar o Ember-1 no lugar do Kimi K3. Em testes A/B com clientes reais, rodando cargas de codificação, a economia foi medida em produção, e não apenas em laboratório. Há relatos de redução ainda maior em cargas específicas de codificação, chegando a patamares bem acima dos 40% gerais.
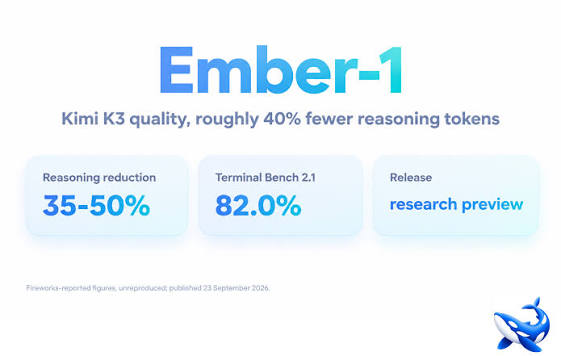
O ganho é maior em fluxos agênticos. Como o raciocínio dos primeiros turnos é relido e recobrado nas chamadas seguintes, encurtar esse raciocínio reduz o custo de forma acumulada. Quanto mais longo o fluxo, maior o efeito. Para quem monta agentes que executam muitas etapas, esse é o argumento principal.
| Aspecto | Kimi K3 | Fireworks Ember-1 |
|---|---|---|
| Base | Modelo de raciocínio original | Derivado do Kimi K3 |
| Tokens de raciocínio | Longos | Cerca de 40% menos |
| Qualidade | Referência | Comparável, segundo a Fireworks |
| Foco | Uso geral | Eficiência em custo |
| Lançamento | Antes de setembro de 2026 | 23 de setembro de 2026 |
O que é o Índice de Inteligência Especializada
Junto com o Ember-1, a Fireworks apresentou uma forma própria de medir modelos, chamada Índice de Inteligência Especializada. A ideia é avaliar modelos especializados por um critério de Pareto, ou seja, pela relação entre qualidade e custo, e não apenas por desempenho bruto.
Isso reflete uma mudança de mentalidade. Durante muito tempo, a pergunta era "Qual modelo é mais inteligente?". Com modelos especializados, a pergunta vira "Qual modelo entrega o resultado de que eu preciso pelo menor custo?". O Ember-1 foi posicionado como um ponto de fronteira nesse índice, combinando qualidade com economia.
Para quem escolhe ferramentas de IA, esse critério é mais útil do que rankings absolutos. Um modelo um pouco menos capaz, mas muito mais barato, pode ser a escolha certa para tarefas repetitivas. E um modelo mais caro faz sentido quando a qualidade é crítica.
Onde o Ember-1 encaixa no uso real
O Ember-1 foi pensado para trabalho que exige raciocínio em volume. Codificação automatizada, agentes que executam tarefas em sequência e fluxos com muitas chamadas são os casos em que a economia de tokens mais compensa.
Se você usa IA apenas para perguntas pontuais, a diferença é pequena, porque o custo por chamada já é baixo. O ganho aparece quando o uso é intenso e repetitivo. Nesses cenários, cortar 40% do raciocínio reduz o gasto mensal de forma perceptível.
Há também uma vantagem de velocidade. Menos tokens gerados significam respostas mais rápidas, o que melhora a experiência em aplicações interativas. Para interfaces que dependem de resposta imediata, essa diferença conta.
Como testar o modelo de raciocínio IA no seu fluxo
Para avaliar se o Ember-1 compensa no seu caso, o caminho é medir antes de trocar. Rodar o mesmo conjunto de tarefas no modelo atual e no Ember-1, comparando custo por execução e qualidade das respostas, dá uma resposta melhor do que qualquer benchmark genérico.
Vale fazer isso com uma amostra real de trabalho, não com perguntas de teste. Instale as ferramentas de acesso pela API ou pelo gateway de IA que você já usa, baixe os pacotes necessários e confira as permissões de chave de API antes de rodar cargas de produção. Como o modelo é novo, mantenha o antigo disponível como alternativa até ter dados suficientes para decidir.
Limitações e o que ainda não se sabe
Como todo modelo especializado, o Ember-1 tem limites. Ele foi ajustado para eficiência, e não necessariamente para tarefas que exigem o raciocínio mais longo e profundo. Em problemas complexos, o ganho de economia pode vir acompanhado de menor margem de qualidade, e isso depende do tipo de tarefa.
A avaliação de qualidade vem em grande parte da própria Fireworks, o que exige cautela. Testes independentes sobre a real equivalência com o Kimi K3 em tarefas do mundo real ainda são limitados. É razoável tratar a promessa com interesse e verificar em cargas próprias antes de migrar tudo.
Também vale notar que o Ember-1 é o primeiro de uma série. Isso significa que o modelo pode evoluir rápido, e que decisões de arquitetura tomadas agora podem precisar de revisão. Para quem depende de estabilidade, acompanhar as atualizações da Fireworks é parte do trabalho.
Dúvidas comuns sobre o Ember-1
O Ember-1 é um modelo novo do zero? Não. Ele foi construído a partir do Kimi K3, da Moonshot AI, com treinamento adicional da Fireworks.
Ele é, portanto, um modelo de raciocínio ia de segunda geração, nascido de um modelo existente.
Ele substitui o Kimi K3? Depende do uso. Em tarefas que exigem eficiência de custo, sim. Em tarefas que exigem o raciocínio mais profundo, a escolha pode ser outra.
A qualidade é realmente a mesma? A Fireworks afirma que sim, com base em benchmarks e testes A/B. Como a avaliação é da própria empresa, vale testar no seu caso.
Onde ele está disponível? Ele foi lançado em 23 de setembro de 2026 e aparece em gateways de IA e plataformas de API parceiras.
Para quem é mais indicado? Desenvolvedores que rodam agentes e fluxos de codificação com muitas chamadas, onde o custo por token pesa.
Ele é um modelo de raciocínio de uso geral? Não. Ele é especializado em eficiência, e tarefas que exigem raciocínio muito longo podem não ser o melhor encaixe.
Conclusão
O Fireworks Ember-1 mostra uma virada importante na forma como a indústria trata modelos de raciocínio. Em vez de fazer modelos cada vez mais capazes a qualquer custo, o foco passa a ser cortar o desperdício: raciocinar menos quando menos basta, mantendo a qualidade. Para quem roda IA em produção, isso vira economia direta, especialmente em fluxos agênticos, onde o excesso de raciocínio se acumula.
Se você desenvolve com IA, vale testar o Ember-1 nas suas cargas de trabalho e comparar custo e qualidade com o que usa hoje. Como a avaliação oficial vem da própria Fireworks, um teste próprio é a melhor medida. E se você só usa IA de forma casual, o impacto é pequeno, mas o conceito por trás do modelo é o que define para onde as ferramentas de IA vão nos próximos anos.
Nota de atualização: Fireworks Ember-1, lançado em 23 de setembro de 2026 pela Fireworks Research. Modelo especializado construído sobre o Kimi K3, da Moonshot AI, com cerca de 40% menos tokens de raciocínio e qualidade comparável, segundo avaliações da própria empresa.
 NEWS
 REVIEWS
 HOWTO