DeepSeek V4.1-Flash: Nueva arquitectura y visión nativa en la actualización
2026-09-11
DeepSeek V4.1-Flash presenta arquitectura MoE Causal Encoder-Decoder de 552B con visión nativa, contexto de 1M y caché KV de 890 bytes por token. Precios de API reducidos, V4 Pro se retira.

DeepSeek publicó V4.1-Flash el 10 de septiembre de 2026, y no es una actualización menor. Este nuevo modelo DeepSeek estrena una arquitectura completamente nueva, incorpora visión nativa y reduce el precio de la API. Si usas la aplicación DeepSeek o su API, esta actualización de IA DeepSeek cambia lo que el modelo puede hacer y cuánto cuesta ejecutarlo.

DeepSeek es una aplicación de asistente oficial para chatear y resolver tareas en Android.
Nueva arquitectura Causal Encoder-Decoder en DeepSeek V4.1 Flash
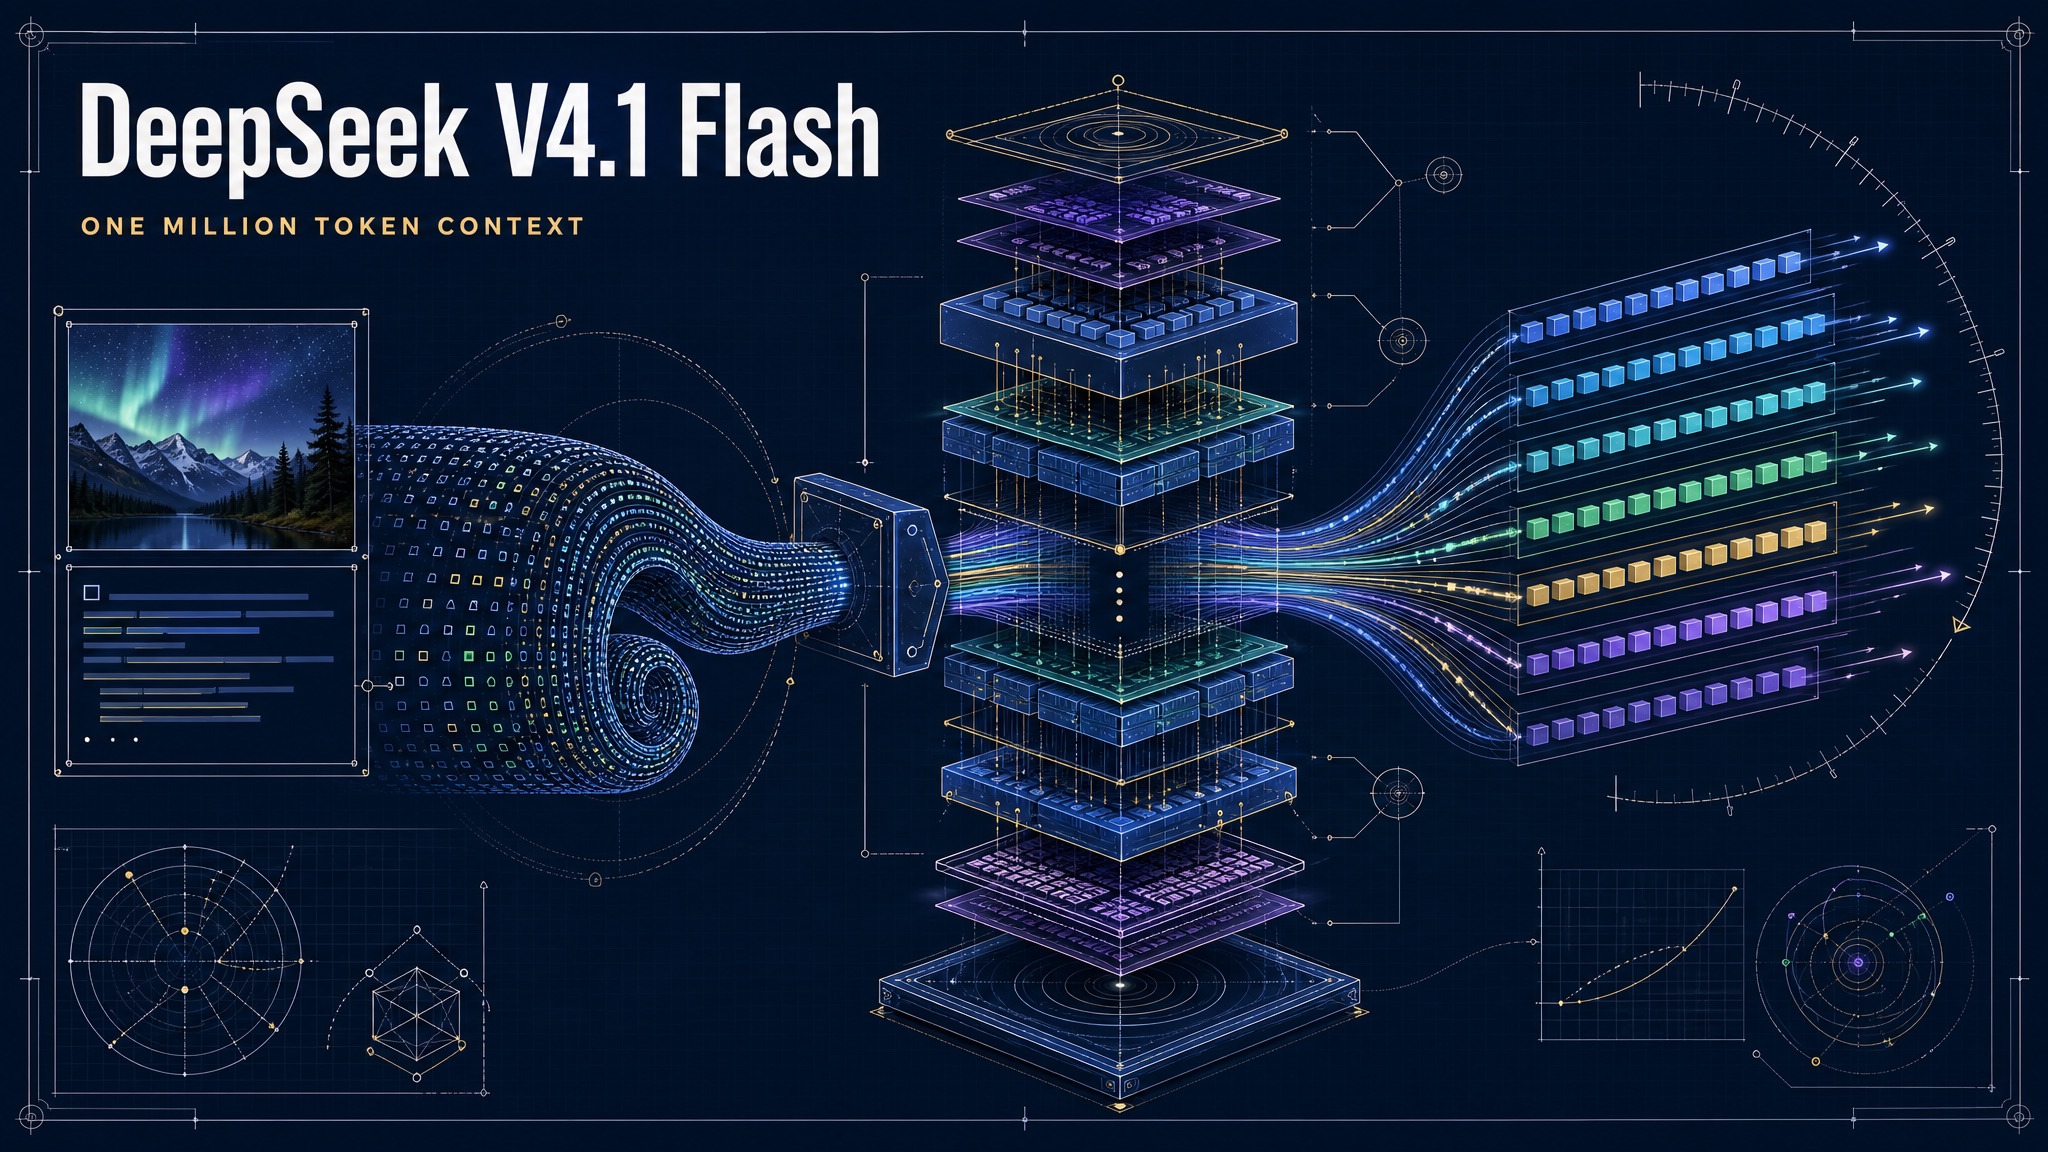
El cambio más profundo está en la estructura del modelo. DeepSeek V4.1-Flash usa una arquitectura Causal Encoder-Decoder (CED), diferente del transformer estándar de V4-Flash. La red principal tiene 40 capas divididas en 20 capas de codificador y 20 de decodificador, y los dos lados no trabajan por igual. El procesamiento de entrada activa solo 8B de parámetros por token. La generación de salida activa 16B. Esa asimetría importa. Los agentes de IA gastan la mayor parte de su capacidad leyendo contexto, no generando texto. Un agente de programación puede leer 30.000 tokens de un repositorio y producir 200 tokens de código. Al abaratar el lado de lectura, DeepSeek ataca exactamente el patrón de trabajo que domina en el uso real de agentes.
La red principal tiene 552B de parámetros en una estructura Mixture-of-Experts, con 196B adicionales en lo que DeepSeek llama memoria condicional Engram. Las capas 1 y 14 contienen estos módulos Engram, que hacen búsquedas dispersas basadas en tokens en lugar de atención densa. Es una respuesta específica a un problema concreto: recuperación de contexto largo sin crecimiento proporcional de memoria.
Visión nativa de DeepSeek: integrada, no añadida
Los modelos anteriores de DeepSeek necesitaban un módulo de visión separado para procesar imágenes. V4-Flash-Vision-Exp era ese módulo, un complemento experimental. V4.1-Flash integra la visión directamente en el modelo base. Puedes enviar una imagen y hacer una pregunta sobre ella en la misma solicitud, y el modelo procesa ambas cosas sin cambiar de modo.
Los formatos compatibles incluyen JPEG, PNG, GIF y WebP. Casos prácticos: análisis de capturas de pantalla, lectura de gráficos, comprensión de páginas web y tareas de agentes visuales donde el modelo necesita mirar algo antes de decidir qué hacer. DeepSeek también unificó sus antiguos modos rápido, experto y de visión en un único modo inteligente que detecta automáticamente si hay una imagen y ajusta la profundidad de razonamiento según la complejidad de la tarea.
Contexto de 1M de DeepSeek y compresión de caché KV
V4.1-Flash soporta una ventana de contexto de 1 millón de tokens. La historia real no es el tamaño de la ventana, sino cuánta memoria consume. ¿Por qué importa esto? Porque el costo de memoria, no el número de parámetros, determina si un modelo es suficientemente económico para ejecutar a escala.
DeepSeek comprime la caché KV global a 890 bytes por token. Eso es aproximadamente una cuarta parte de lo que necesitaba V4-Flash y una cuatrocientosava parte de lo que consumía DeepSeek V1. Dos técnicas lo hacen posible. Primero, CSA2 (Atención Dispersa Comprimida 2) comparte estados de clave-valor entre capas en tres modos: Full, Reindex y Reuse. Una capa Full calcula su propia caché KV. Una capa Reindex reutiliza la caché de la última capa Full pero la reevalúa. Una capa Reuse toma tanto la caché como los índices sin recalcular. Segundo, la caché KV principal se almacena en formato FP4 (E2M1 con escalado E4M3), lo que reduce el almacenamiento casi a la mitad comparado con el FP8 de V4.
En el lado del despliegue, la atención de ventana deslizante ya no se escribe en SSD. Vive en un pool distribuido de DRAM con un tiempo de vida de minutos. Cuando una solicitud falla en esa caché, el sistema solo reproduce los últimos 128 tokens en lugar del contexto completo. DeepSeek llama a esto Encoder SWA Bounded Replay, y reduce la caché persistente a aproximadamente una octava parte de V4-Flash.
Resultados de benchmarks de DeepSeek V4.1 Flash
Los números de DeepSeek sitúan a V4.1-Flash por delante de V4 Pro en la mayoría de tareas de agentes y programación:
| Benchmark | V4.1-Flash | V4-Flash | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 82.7 | 89.1 | 88.8 |
| DeepSWE v1.1 | 74.2 | 54.4 | 74.0 | 73.0 |
| Automation-Bench | 54.8 | 37.7 | 50.3 | 45.8 |
| GPQA Diamond | 90.9 | 89.9 | 93.4 | 94.1 |
| Codeforces (rating) | 3471 | 3289 | N/A | N/A |
Supera a Opus 5 y GPT-5.6 Sol en Terminal-Bench 2.1 y DeepSWE v1.1, que son benchmarks de agentes y programación. GPQA Diamond cuenta otra historia. V4.1-Flash puntúa 90.9, sólido pero por debajo de Opus 5 (93.4) y GPT-5.6 Sol (94.1). Así que no es un modelo que gane en cada categoría. Es un modelo que gana donde los agentes realmente pasan su tiempo: leyendo, dirigiendo y ejecutando tareas. ¿Puede reemplazar a un modelo de primer nivel en razonamiento científico? Todavía no.
Precios más bajos de la API y retirada de V4 Pro
DeepSeek redujo los precios de V4.1-Flash desde el 10 de septiembre de 2026. El modelo usa precios de hora pico y valle. En hora valle, la entrada con caché hitada cuesta 0.02 yuanes por millón de tokens, la entrada sin caché hitada cuesta 1 yuan y la salida cuesta 4 yuanes. Las horas pico duplican esas tarifas. Para comparar, el antiguo V4-Flash cobraba 0.05 yuanes para entrada con caché hitada, 1.5 yuanes para entrada sin caché hitada y 4.5 yuanes para salida.
V4 Pro se está retirando. Desde el 14 de septiembre de 2026, las solicitudes a deepseek-v4-pro se redirigen a V4.1-Flash y se facturan al precio de Flash. La tarifa de salida de V4 Pro era aproximadamente tres veces lo que cobra V4.1-Flash. Los desarrolladores no necesitan cambiar su código. El nombre del modelo deepseek-flash ahora apunta a V4.1-Flash, y los nombres heredados como deepseek-v4-flash y deepseek-v4-flash-vision-exp también se redirigen a él por compatibilidad.
¿Qué significa para los usuarios de la aplicación DeepSeek?
Si usas la aplicación DeepSeek en tu teléfono, los cambios aparecen de dos formas. Primero, el modo inteligente unificado significa que ya no eliges entre modo rápido, experto o de visión. El modelo determina lo que necesitas según tu entrada. Envía una captura de pantalla con una pregunta y la visión se activa automáticamente. Haz una pregunta de razonamiento complejo y el modelo aumenta la intensidad de pensamiento. Segundo, las respuestas deberían ser más rápidas y más baratas de producir, lo que importa para servicios que ofrecen precios basados en uso o límites de frecuencia.
La ventana de contexto de 1M es más relevante para desarrolladores que ejecutan cargas de agentes que para chat casual. Pero si has estado pegando documentos largos en DeepSeek y llegando a límites de contexto, V4.1-Flash maneja más texto por conversación. La compresión de caché KV significa que el lado del servidor puede atender más usuarios simultáneos sin escalar hardware proporcionalmente, que es parte de por qué el precio bajó.
DeepSeek es una aplicación de asistente oficial para chatear y resolver tareas en Android.
¿Vale la pena actualizar DeepSeek V4.1-Flash?
Sí. V4.1-Flash es un modelo mejor a un precio más bajo, y ya es la opción predeterminada si usas la aplicación o la API. Puedes descargar la última aplicación DeepSeek desde APKPure para obtener la experiencia actualizada en tu teléfono. El cambio de arquitectura no es marketing. La activación asimétrica y la compresión de caché KV son decisiones de ingeniería medibles que afectan directamente la velocidad y el costo. Si estabas en V4 Pro, el cambio de redirección el 14 de septiembre gestiona la transición automáticamente, y tu factura baja. Si estabas en V4-Flash, ya estás recibiendo V4.1-Flash cuando llamas a deepseek-flash.
Una advertencia: V4.1-Flash no supera a los modelos cerrados de primer nivel en todos los benchmarks. GPQA Diamond, Terminal-Bench 4.0 y algunas tareas de agentes de larga duración todavía favorecen a Opus 5 o GPT-5.6 Sol. Pero a una fracción de su costo, con pesos abiertos bajo licencia MIT en HuggingFace, es la mejor opción de valor por token en la oferta actual de DeepSeek.
Como con cualquier herramienta de IA, ten en cuenta la privacidad al compartir información personal en el chat y revisa los permisos de la aplicación antes de instalar.
Nota de actualización: 10 de septiembre de 2026. DeepSeek V4.1-Flash. Nueva arquitectura Causal Encoder-Decoder, red principal MoE de 552B, 196B de parámetros Engram, visión nativa, contexto de 1M, caché KV de 890 bytes por token, licencia MIT. Las solicitudes a V4 Pro se redirigen a V4.1-Flash desde el 14 de septiembre de 2026.
 NEWS
 REVIEWS
 HOWTO