OpenAI ha publicado los resultados de Benchmark del Chip Jalapeño
2026-08-26
OpenAI publicó los primeros resultados de benchmark de su chip personalizado de inferencia de IA, Jalapeño, mostrando mejoras significativas.
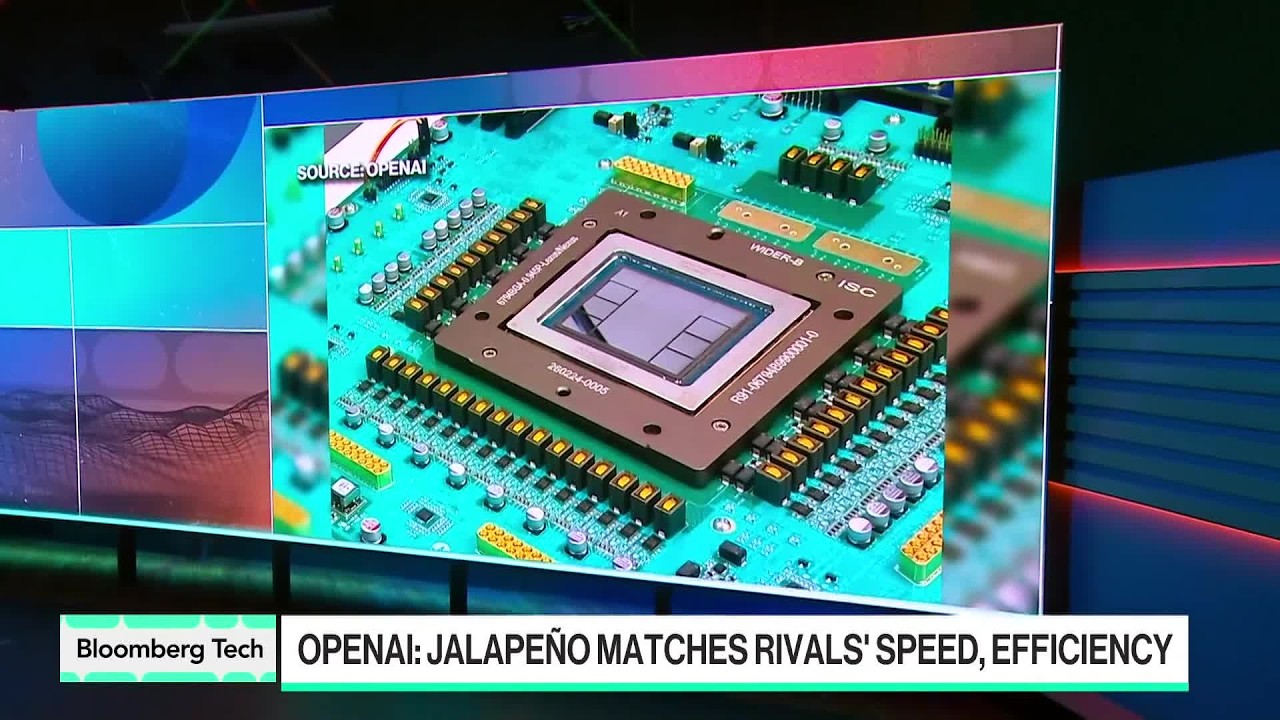
OpenAI publicó los primeros resultados de benchmark de su chip personalizado de inferencia de IA, Jalapeño, el 25 de agosto de 2026. Las cifras son lo suficientemente importantes como para interesar a cualquier persona que use ChatGPT en el teléfono. El chip ofrece respuestas más rápidas, atiende a más usuarios simultáneos por vatio y procesa modelos de lenguaje grandes con mayor eficiencia que el hardware actual de Nvidia. Si usas ChatGPT o cualquier aplicación construida sobre modelos de OpenAI, el chip OpenAI Jalapeño importa porque afecta directamente a la velocidad y la fiabilidad de las respuestas.

Qué es el chip OpenAI Jalapeño
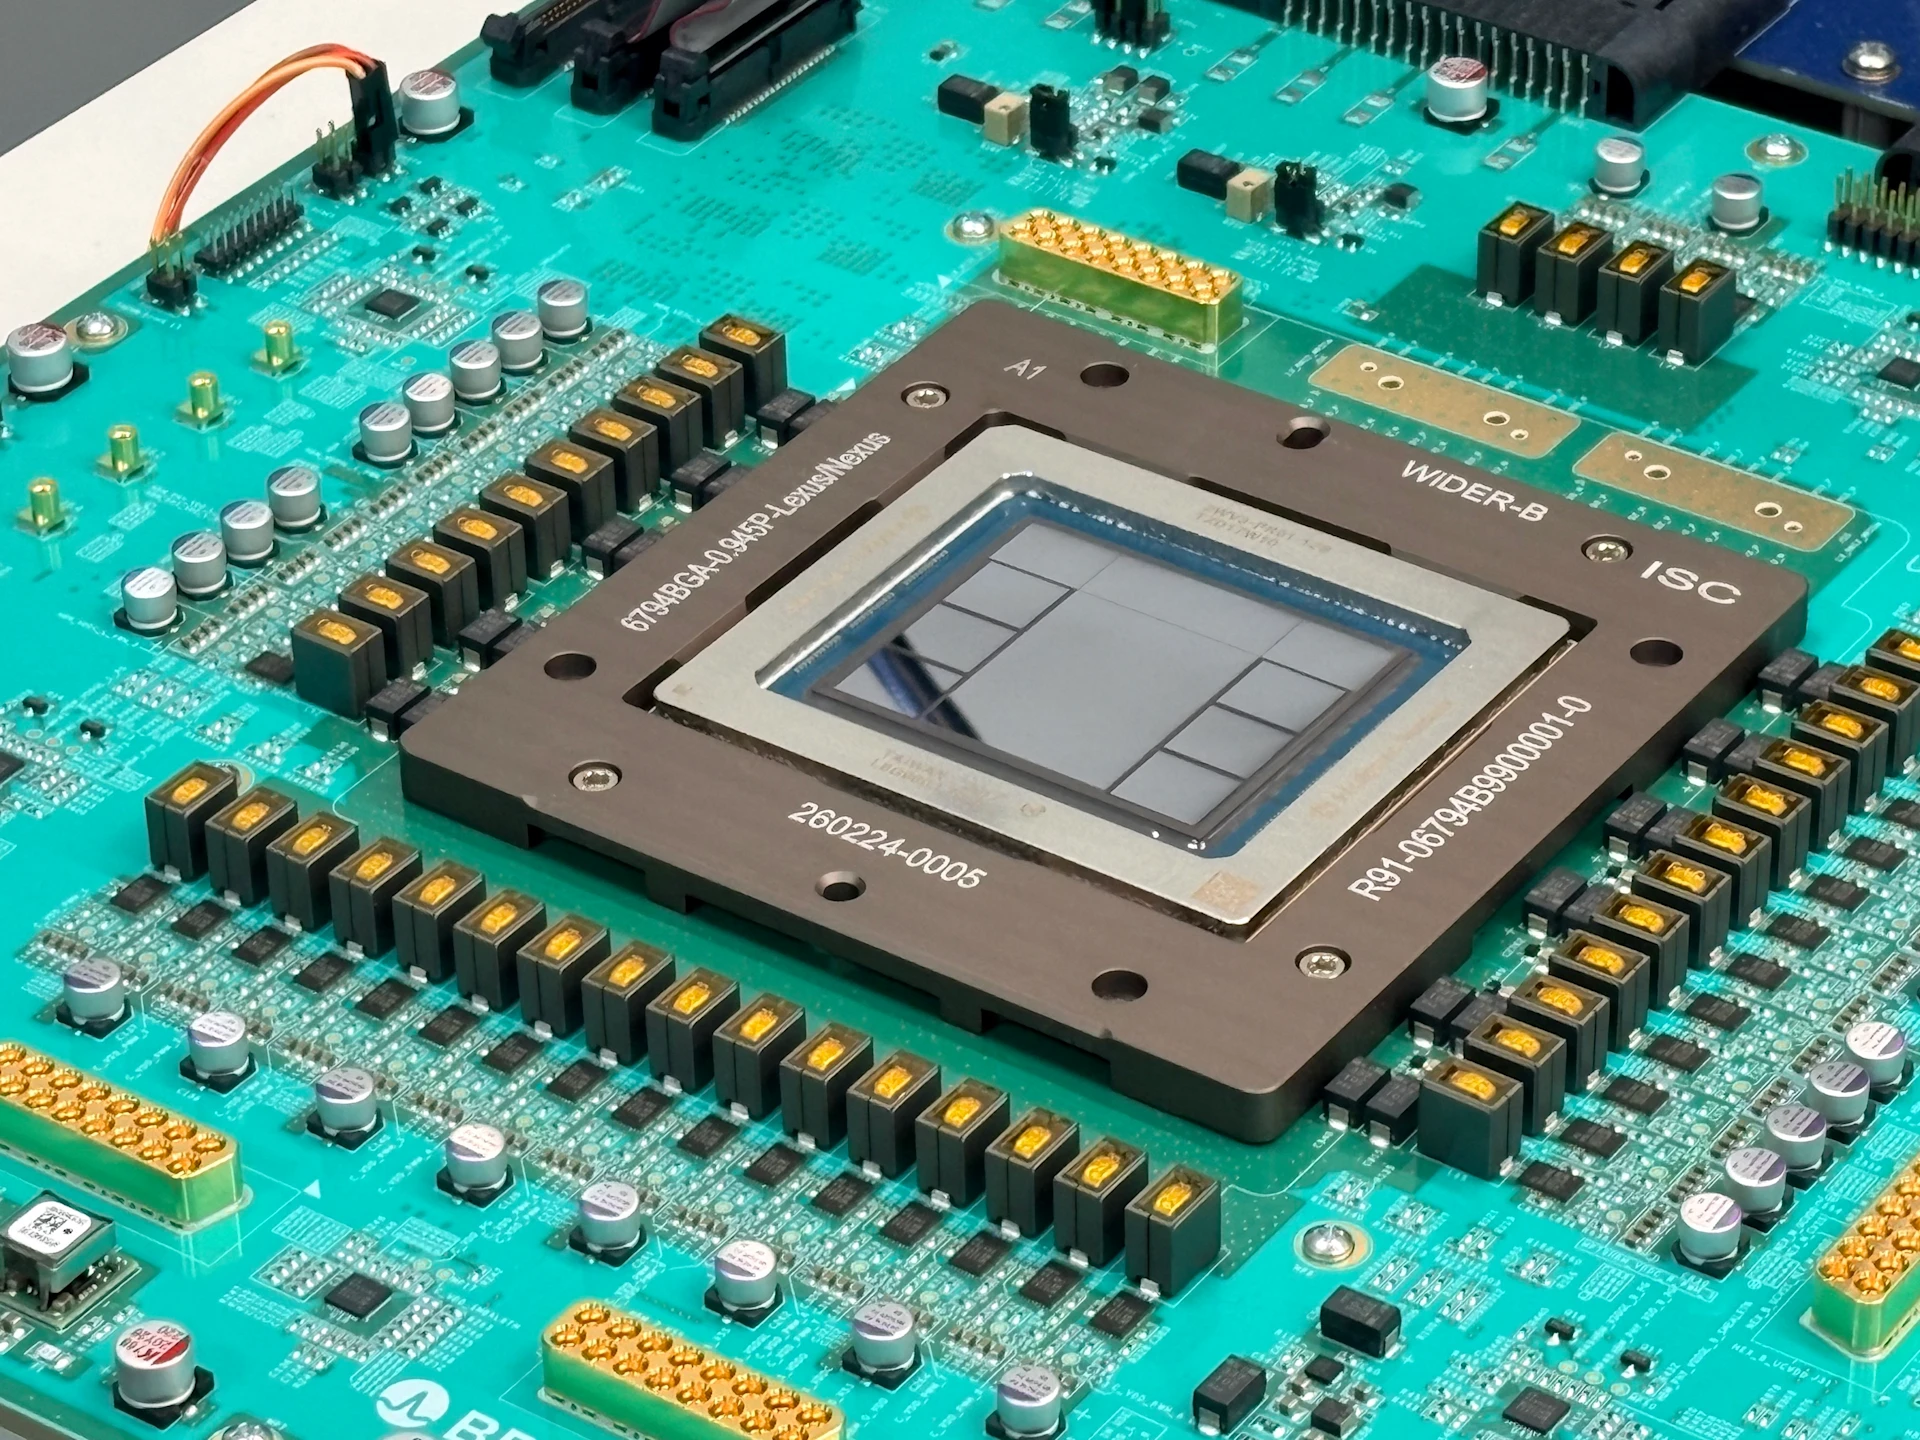
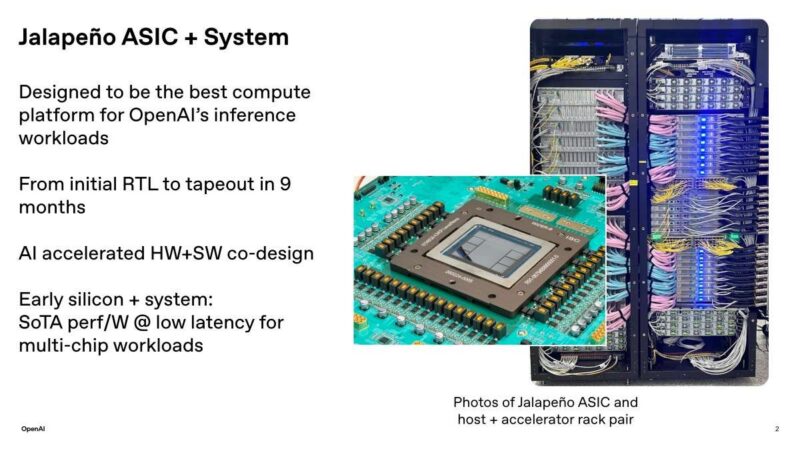
Jalapeño es un circuito integrado de aplicación específica, o ASIC, construido en colaboración con Broadcom. OpenAI lo presentó en junio de 2026 como su primer chip personalizado diseñado específicamente para inferencia de IA. A diferencia de las GPU de propósito general, que se utilizan tanto para entrenamiento como para inferencia, Jalapeño se centra en una única tarea: ejecutar modelos ya entrenados para atender solicitudes de los usuarios. Esta especialización marca la diferencia. Cuando diseñas un chip para un solo propósito, puedes eliminar todo lo que no sea necesario y destinar los recursos a las partes que realmente importan.
El chip funciona con una potencia nominal de 700 vatios, aunque su consumo real durante las pruebas se mantuvo en 550 vatios o menos. El equipo de hardware de OpenAI lo construyó desde cero para minimizar el movimiento de datos entre unidades de procesamiento, una de las principales fuentes de latencia en la inferencia de IA. El estado del modelo, incluido el caché KV utilizado durante la generación de respuestas, permanece local en lugar de moverse entre chips.
Esta decisión arquitectónica explicaría por qué Jalapeño puede ofrecer un mayor rendimiento y una menor latencia al mismo tiempo, mientras que los sistemas competidores normalmente exigen elegir entre ambos factores.
Resultados del benchmark de Jalapeño frente al hardware de Nvidia
OpenAI probó Jalapeño en InferenceX, una plataforma pública de benchmarking de SemiAnalysis que mide el proceso completo de atender una solicitud de IA. Los sistemas de comparación fueron los superchips Nvidia GB200 y GB300, que representaban el hardware comercial más avanzado disponible en el momento de las pruebas.
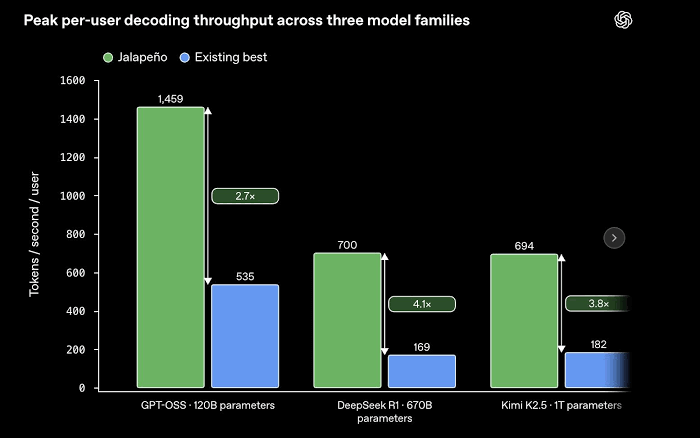
Los resultados abarcaron tres modelos de pesos abiertos: GPT-OSS 120B, DeepSeek R1 670B y Kimi K2.5 1T. Estas son las principales cifras:
- Entre 1,5 y 1,9 veces más trabajo de IA por vatio en el pico de rendimiento de los tres modelos.
- Entre 1,7 y 3,6 veces menos latencia de extremo a extremo en los tres modelos.
- Entre 2,1 y 4,1 veces más rendimiento en cargas de trabajo altamente interactivas.
- En Kimi K2.5 1T, el modelo más grande probado, Jalapeño ofreció 3,4 veces menos latencia.
La comparación utilizó las clasificaciones de potencia publicadas para cada acelerador. Jalapeño está clasificado en 700 vatios, frente a los 1.200 vatios del GB200 y los 1.400 vatios del GB300. En otras palabras, Jalapeño logró estas mejoras consumiendo significativamente menos energía que las alternativas de Nvidia.
| Modelo | Ganancia de Rendimiento/Vatio | Reducción de Latencia |
|---|---|---|
| GPT-OSS 120B | 1.9x mayor | 1.7x menor |
| DeepSeek R1 670B | 1.7x mayor | 3.6x menor |
| Kimi K2.5 1T | 1.5x mayor | 3.4x menor |
Para GPT-OSS 120B específicamente, Jalapeño entregó 85.448 tokens mixtos por segundo por kilovatio, frente a los 44.960 del GB200. En DeepSeek R1, logró 19.641 frente a 11.781. No son mejoras marginales, sino un cambio significativo en la eficiencia con la que se puede realizar la inferencia de IA.
Cómo Jalapeño procesa la inferencia de IA de forma diferente
La inferencia de modelos de lenguaje tiene fases distintas. El prefill, cuando el sistema procesa el prompt, es intensivo en computación. El decode, cuando el sistema genera la respuesta token por token, está limitado por el ancho de banda de memoria. Un chip que destaca en prefill puede detenerse durante el decode mientras espera que los datos se muevan entre núcleos.
La arquitectura de Jalapeño aborda este problema manteniendo local el estado del modelo y activando la combinación adecuada de computación, memoria y red para cada fase. El chip utiliza un dominio grande que permite que toda la carga de trabajo permanezca dentro de un sistema conectado. Esto reduce los retrasos de comunicación, que es donde las GPU de propósito general pierden tiempo.
El resultado es un acelerador equilibrado, capaz de manejar tanto el prefill como el decode y de adaptarse a medida que cambia el equilibrio entre ambos. Esta adaptabilidad lo hace especialmente adecuado para cargas de trabajo agénticas, en las que las tareas se ejecutan en múltiples pasos y los retrasos se acumulan.
Qué significa esto para los usuarios de ChatGPT en móviles
Si utilizas la aplicación ChatGPT en Android, no interactuarás directamente con el hardware Jalapeño. El chip está en los centros de datos de OpenAI, no en tu teléfono. Sin embargo, las mejoras de rendimiento se traducen en beneficios visibles para el usuario de tres maneras.
Primero, una menor latencia de extremo a extremo significa que las respuestas comienzan más rápido. En los modelos más grandes probados, la latencia se redujo más de tres veces. Para los agentes interactivos que necesitan completar múltiples pasos en secuencia, estos ahorros se acumulan. Una tarea que requiere cinco llamadas secuenciales de inferencia podría obtener una reducción proporcional en el tiempo total de espera.
Segundo, un mayor rendimiento por vatio significa que OpenAI puede atender a más usuarios simultáneamente con el mismo presupuesto energético. Durante las horas punta, esto podría traducirse en menos límites de tasa, menos retrasos en las colas y un acceso más fiable. Si alguna vez has visto el mensaje «ChatGPT está al límite de capacidad», un hardware más eficiente puede ayudar a resolver directamente ese problema.
Tercero, el costo por inferencia disminuye. OpenAI declaró explícitamente que Jalapeño puede mejorar los márgenes operativos al permitir que el trabajo útil y los ingresos crezcan más rápido que el costo de servicio. Unos costos más bajos facilitan ofrecer modelos capaces en niveles de suscripción más económicos o incluso de forma gratuita.
Los beneficios del chip de IA de ChatGPT llegarían finalmente a los usuarios en forma de mayor disponibilidad y respuestas más rápidas.
Calendario de despliegue y asociación con Nvidia
OpenAI planea desplegar Jalapeño en pequeños volúmenes para finales de 2026, con un aumento de la producción durante 2027. La empresa no ha revelado cifras específicas de despliegue. Se trata de un chip de primera generación, y OpenAI ya está desarrollando las generaciones segunda y tercera.
Sin embargo, Jalapeño no reemplazará por completo al hardware de Nvidia. Richard Ho, vicepresidente de hardware de OpenAI, declaró durante una rueda de prensa que la estrategia general de computación de la empresa incluye «socios muy buenos» y que OpenAI no espera sustituir toda su línea de chips con Jalapeño. La compañía continuará desplegando aceleradores de Nvidia para cargas de trabajo de entrenamiento e inferencia junto con su silicio personalizado.
Este enfoque dual tiene sentido. Las GPU de Nvidia son de propósito general y pueden adaptarse rápidamente a nuevas arquitecturas de modelos. Jalapeño está optimizado para las cargas de trabajo específicas que OpenAI ejecuta actualmente, pero adaptarlo a nuevas familias de modelos todavía requiere nuevos kernels y ajustes específicos para cada modelo. La flexibilidad del hardware de Nvidia cubre carencias que el silicio especializado aún no puede resolver.
IA utilizada para diseñar y programar el chip
Uno de los detalles más llamativos del blog de OpenAI es que la propia IA desempeñó un papel directo en el desarrollo de Jalapeño. El equipo pasó del diseño inicial al tapeout en nueve meses, utilizando modelos anteriores de OpenAI para explorar implementaciones y acortar los ciclos de diseño. La IA también ayudó a mejorar los circuitos aritméticos del chip, lo que permitió incluir un mayor rendimiento de computación en el espacio disponible.
En el ámbito de la programación, los ingenieros utilizaron Codex con GPT-Astra para llevar tres modelos de pesos abiertos a un alto rendimiento en Jalapeño en solo dos meses, incluidos modelos que no formaban parte del plan de producción original.
Para determinados bloques de atención y de mixture-of-experts de GPT-OSS, las implementaciones generadas por IA funcionaron entre 1,5 y 1,8 veces más rápido que las versiones escritas por expertos humanos. Estas cifras se aplican a bloques seleccionados, no al modelo completo, pero apuntan a un ciclo de desarrollo en el que cada generación de chips mejora con los modelos que se ejecutan en la generación anterior.
Por qué el chip de OpenAI importa para las aplicaciones de IA
Los resultados del benchmark de Jalapeño importan más allá de las cifras brutas de rendimiento. Muestran que una empresa que desarrolla modelos de IA también puede construir hardware capaz de ejecutar esos modelos con mayor eficiencia que las mejores alternativas de propósito general. Esta integración vertical, desde el diseño de los modelos hasta el silicio, permite a OpenAI optimizar conjuntamente cada capa de la pila tecnológica.
Para el sector más amplio de las aplicaciones de IA, un mejor hardware de inferencia significa que los desarrolladores pueden crear aplicaciones agénticas más complejas sin encontrarse con límites de latencia. Si estás desarrollando sobre la API de ChatGPT o utilizando modelos de OpenAI en tu aplicación para Android, una inferencia más rápida y económica ofrece mayor margen para crear experiencias ágiles y receptivas en dispositivos móviles. La brecha entre un modelo que se ejecuta en un centro de datos y una aplicación que parece instantánea en el teléfono se reduce.
La presión competitiva también puede impulsar a Nvidia y a otros proveedores de hardware a mejorar más rápido. Las alternativas más eficientes podrían trasladar parte del poder de negociación hacia los compradores, incluidos los proveedores de servicios en la nube y, en última instancia, los desarrolladores de aplicaciones y los usuarios finales. Si utilizas aplicaciones de IA en Android, la competencia entre el silicio personalizado de OpenAI y las GPU de Nvidia puede afectar directamente la calidad de tu experiencia.
La conclusión es clara: Jalapeño no es solo una historia de hardware para ingenieros de centros de datos. Es una capa de infraestructura que puede determinar la rapidez con la que responden tus aplicaciones de IA y cuánto cuesta operarlas. Los primeros resultados de benchmark atribuidos a OpenAI sugieren que la empresa se toma en serio la posibilidad de construir esta capa internamente, en lugar de depender exclusivamente de proveedores externos.
Para experimentar las funciones de IA que podrían beneficiarse de estas mejoras de infraestructura, descarga la aplicación oficial de ChatGPT desde una fuente autorizada, como Google Play. La aplicación ofrece acceso a los modelos de OpenAI en dispositivos Android. A medida que el hardware de inferencia se incorpore a la infraestructura de OpenAI, cualquier mejora de disponibilidad o latencia debería llegar al usuario sin necesidad de actualizar el hardware del teléfono.
Nota sobre seguridad y privacidad
Los resultados del benchmark se basan en las pruebas comunicadas por OpenAI y en datos públicos de InferenceX. El rendimiento real en dispositivos móviles depende de la conexión de red, las capacidades del dispositivo y la carga actual de los servidores.
Verifica siempre el desarrollador y la fuente antes de instalar una aplicación. No debe afirmarse que una copia distribuida mediante APKPure es necesariamente el cliente oficial de OpenAI sin confirmación de la propia empresa. Tus conversaciones se gestionan conforme a la política de privacidad aplicable de OpenAI. El calendario de despliegue puede cambiar mientras continúan la validación para producción y la maduración del software.
 NEWS
 REVIEWS
 HOWTO