VoiceStudio: Alternativa del código abierto a ElevenLabs
2026-09-30
VoiceStudio es la alternativa del código abierto a ElevenLabs con clonación de voz y texto a voz local en 646 idiomas. Te explicamos cómo funciona y qué límites tiene.
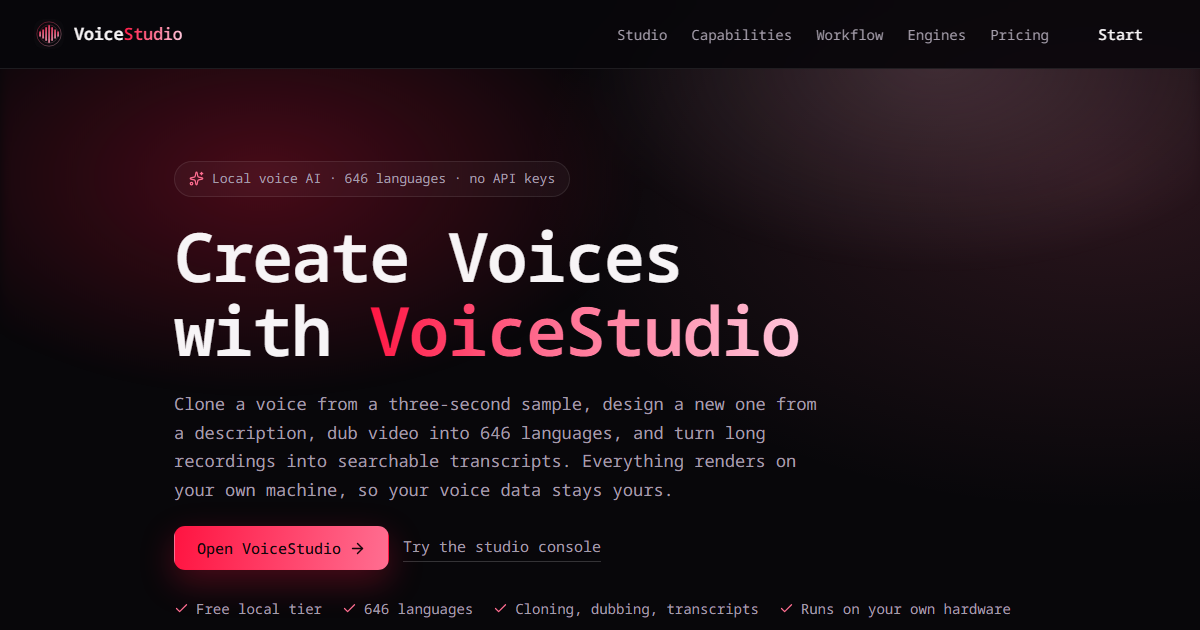
VoiceStudio es una aplicación de escritorio de código abierto que hace clonación de voz, doblaje de vídeo, dictado y audiolibros directamente en tu ordenador. Se presenta como la alternativa open source a ElevenLabs, y la comparación no es casual: cubre las mismas tareas, pero sin enviar tu audio a un servidor ajeno y sin suscripción. Si te preocupa dónde acaban tus grabaciones o simplemente no quieres pagar una cuota mensual, merece un vistazo.
Lo probé porque el sector de la voz sintética está dividido entre servicios en la nube cómodos y caros, y herramientas locales potentes pero difíciles de montar. VoiceStudio intenta cerrar esa brecha con una app de escritorio que no exige conocimientos técnicos. Te explico qué es, qué puede hacer y qué límites tiene.
Qué es VoiceStudio y quién está detrás
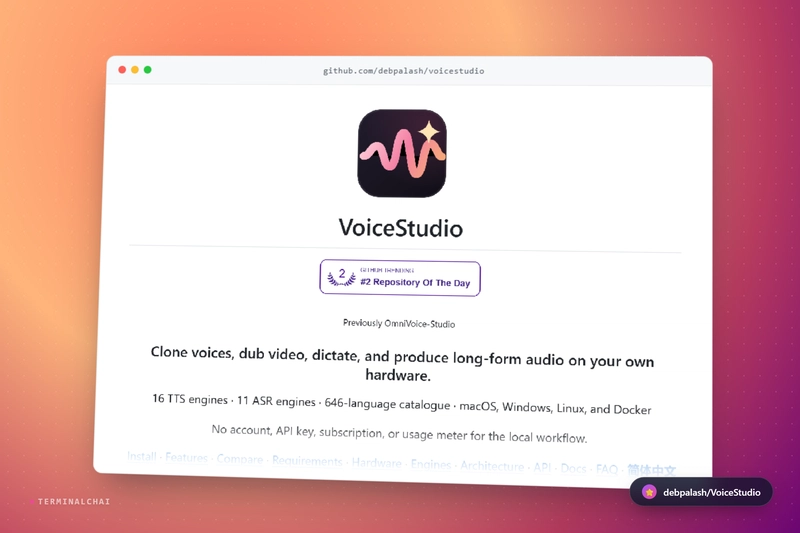
VoiceStudio es un proyecto open source del desarrollador Palash Debnath, publicado en GitHub bajo la licencia AGPL-3.0. Antes se llamaba OmniVoice Studio, y ese nombre viejo todavía aparece en alguna cobertura, así que si lo buscas, ten presente que es el mismo proyecto.
La propuesta es directa. Todo el procesamiento ocurre en tu hardware. Los flujos locales no dependen de la nube, y los servicios remotos son opcionales. Esa arquitectura es la diferencia central frente a herramientas como ElevenLabs, donde cada archivo que procesas pasa por servidores externos.
El motor por defecto se apoya en k2-fsa/OmniVoice, y el proyecto ha crecido hasta convertirse en un kit bastante amplio: no solo clona voces, también las diseña desde cero, dobla vídeos y transcribe audio.
Es más que un clonador de voces. Es casi una suite de audio.
Clonación de voz open source desde un clip corto
La función principal es la clonación de voz, y aquí el dato que sorprende es cuánto audio necesita. VoiceStudio trabaja con un clip de tres segundos. Usa aprendizaje zero-shot, lo que significa que clona una voz que nunca vio en el entrenamiento, condicionando un modelo de texto a voz basado en difusión sobre esa referencia corta.
Para quien no está familiarizado con el término, el zero-shot es lo que hace que no tengas que grabar horas de audio ni entrenar un modelo durante días. Grabas unos segundos, subes el clip, escribes el texto y generas. Así de simple. Esa es la promesa de la clonación de voz open source llevada a una app de escritorio.
El motor subyacente soporta más de 600 idiomas, y el proyecto declara compatibilidad con 646 idiomas para la síntesis. En transcripción, el número baja a 99 idiomas mediante WhisperX.
Texto a voz local: cómo funciona por dentro
El diseño de VoiceStudio separa la interfaz del motor. La app usa un frontend en React que habla con un backend en FastAPI, y ese backend expone 97 puntos de API con actualizaciones por eventos del servidor. Los datos se guardan en SQLite.
Cuatro bibliotecas hacen el trabajo pesado. WhisperX gestiona el reconocimiento de voz con alineación a nivel de palabra. Demucs, de Meta, separa la voz de la música de fondo y conserva ambas pistas. Pyannote se encarga de la diarización, es decir, de identificar qué hablante dijo qué en un audio con varias voces. Y AudioSeal, también de Meta, incrusta una marca de agua neuronal invisible en el audio generado, que sobrevive a la compresión y sirve como metadato de procedencia de IA.
Esa última pieza importa más de lo que parece. Si publicas voces generadas, la marca de agua permite rastrear que el audio es sintético, algo cada vez más relevante a medida que la regulación avanza.
El soporte de GPU es automático: el backend detecta CUDA para NVIDIA, MPS para Apple Silicon y ROCm para AMD. Con 8 GB de VRAM o menos, el motor de texto a voz se descarga a la CPU durante la transcripción sin que tengas que configurar nada.
Más allá del texto a voz: doblaje, dictado y audiolibros
VoiceStudio no se queda en convertir texto en voz. El doblaje de vídeo toma una URL de YouTube o un archivo local, transcribe con WhisperX, traduce el texto, sintetiza el nuevo audio y exporta un MP4. Todo el proceso corre en local.
El widget de dictado es una superposición flotante que funciona en todo el sistema. En macOS se activa con un atajo desde cualquier aplicación, transmite la transcripción por WebSocket y la pega automáticamente en la app que tengas en primer plano.
La cola por lotes permite dejar hasta 50 vídeos procesándose y olvidarte, con barras de progreso por trabajo. Y el servidor MCP expone las capacidades del programa a cualquier cliente compatible. Eso abre la puerta a integrarlo en flujos automatizados.
No es solo una herramienta de voz. Es una base sobre la que construir.
Pros y limitaciones de usar VoiceStudio
Los puntos a favor son claros. El procesamiento local protege la privacidad: tus grabaciones no salen de tu equipo. No hay suscripción ni cuenta en la nube. La cobertura de idiomas supera con creces a la de los servicios comerciales habituales, y el código está abierto para auditar o extender.
Las limitaciones también cuestan de asumir. Una GPU es opcional, pero sin ella el texto a voz va unas tres veces más lento en CPU. La instalación, aunque tiene un comando único para macOS y Linux, sigue pidiendo herramientas como ffmpeg, Bun y uv si quieres compilar desde el código. Y como proyecto individual, el soporte depende de una sola persona, con lo que eso implica en ritmo de actualizaciones.
| Aspecto | Detalle |
|---|---|
| Licencia | AGPL-3.0 |
| Idiomas de síntesis | 646 |
| Idiomas de transcripción | 99 (WhisperX) |
| Requisito de RAM | 8 GB mínimo, 16 GB recomendado |
| GPU | Opcional, con detección automática |
| Plataformas | macOS, Windows y Linux |
Cuándo te conviene y cuándo no
VoiceStudio encaja si haces doblaje de contenido multilingüe, si produces audiolibros o si necesitas clonar una voz sin ceder tus audios a un tercero. También es buena opción si trabajas con idiomas que los servicios comerciales cubren mal, porque pocas herramientas comerciales llegan a los 646 idiomas que declara el proyecto.
No es la elección más cómoda si buscas cero configuración. Una app en la nube sigue siendo más simple de arrancar, y si no tienes GPU, la velocidad local puede frustrar. Para uso profesional con volumen alto y sin hardware dedicado, la balanza se inclina hacia las opciones alojadas.
Mi recomendación es probarla en un equipo con GPU y ver si el flujo de trabajo encaja. Si solo la quieres para un proyecto puntual, el esfuerzo de instalación puede no compensar frente a una herramienta en la nube.
Conclusión
VoiceStudio es una alternativa seria a ElevenLabs para quien prioriza control, privacidad y coste cero a cambio de gestionar su propio hardware. La clonación desde tres segundos, el doblaje completo en local y la marca de agua de procedencia son funciones que hace unos años solo estaban disponibles en servicios de pago.
Merece la pena para creadores, traductores y equipos que manejan audio sensible. Lo que hay que vigilar es el ritmo del proyecto: si el desarrollo se mantiene activo y aparece soporte para más motores, VoiceStudio puede convertirse en la opción de referencia para la síntesis de voz local.
 NEWS
 REVIEWS
 HOWTO