EmbeddingGemma 2: o modelo de embedding multimodal do Google
O EmbeddingGemma 2 leva embeddings no dispositivo para outro nível, unindo texto, imagem, áudio e vídeo em um modelo aberto e leve de 740 milhões de parâmetros.
EmbeddingGemma 2 é um modelo de inteligência artificial que transforma texto, imagens, áudio, vídeo e código em uma representação numérica única, e isso parece abstrato até você entender o que ele resolve. Lançado pelo Google DeepMind em 6 de outubro de 2026, ele foi feito para rodar direto no seu aparelho, sem mandar dados para a nuvem. Se você usa buscadores, assistentes ou apps de organização, esse tipo de tecnologia trabalha nos bastidores o tempo todo.
Neste texto, explicamos o que é um modelo de embedding do Google na prática, como ele funciona, por que rodar isso no celular é importante e em quais situações ele aparece no seu dia a dia.
O que é um modelo de embedding
Um embedding é uma forma de representar o significado de algo como uma sequência de números. Parece estranho, mas é o truque que permite a um computador comparar significados em vez de apenas comparar palavras exatas.
Pense em três frases: "o gato dorme no sofá", "o felino descansa no móvel" e "o cachorro late na rua". Um programa comum vê três conjuntos de palavras diferentes. Um modelo de embedding percebe que as duas primeiras falam de algo parecido e que a terceira é um assunto distinto. Essa percepção é o que torna a busca inteligente possível.
É assim que um app consegue encontrar o arquivo que você quer mesmo quando você não lembra o nome exato. Ele compara significados, não apenas letras. Sem embeddings, a busca seria só uma correspondência mecânica de palavras.
Por que o EmbeddingGemma 2 é multimodal
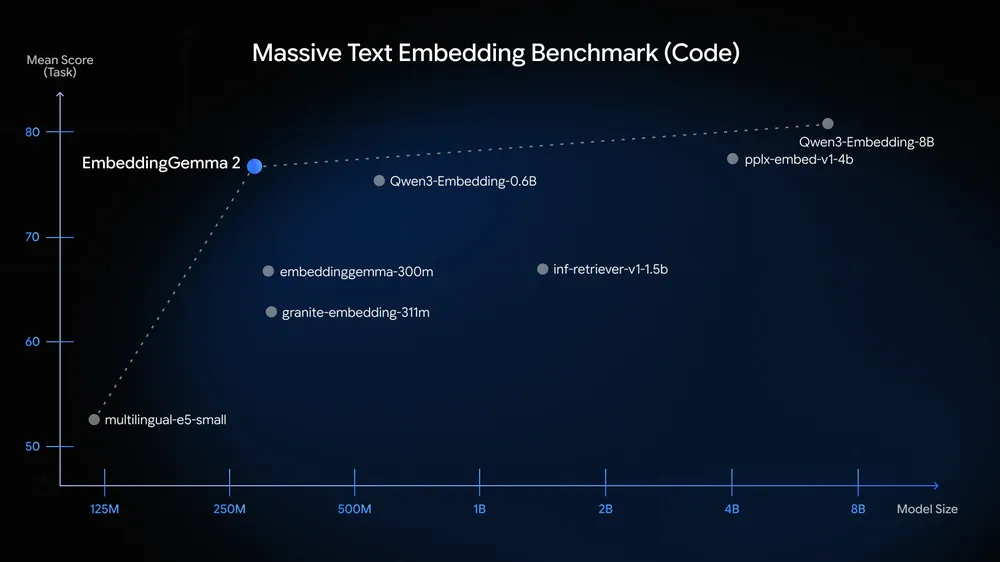
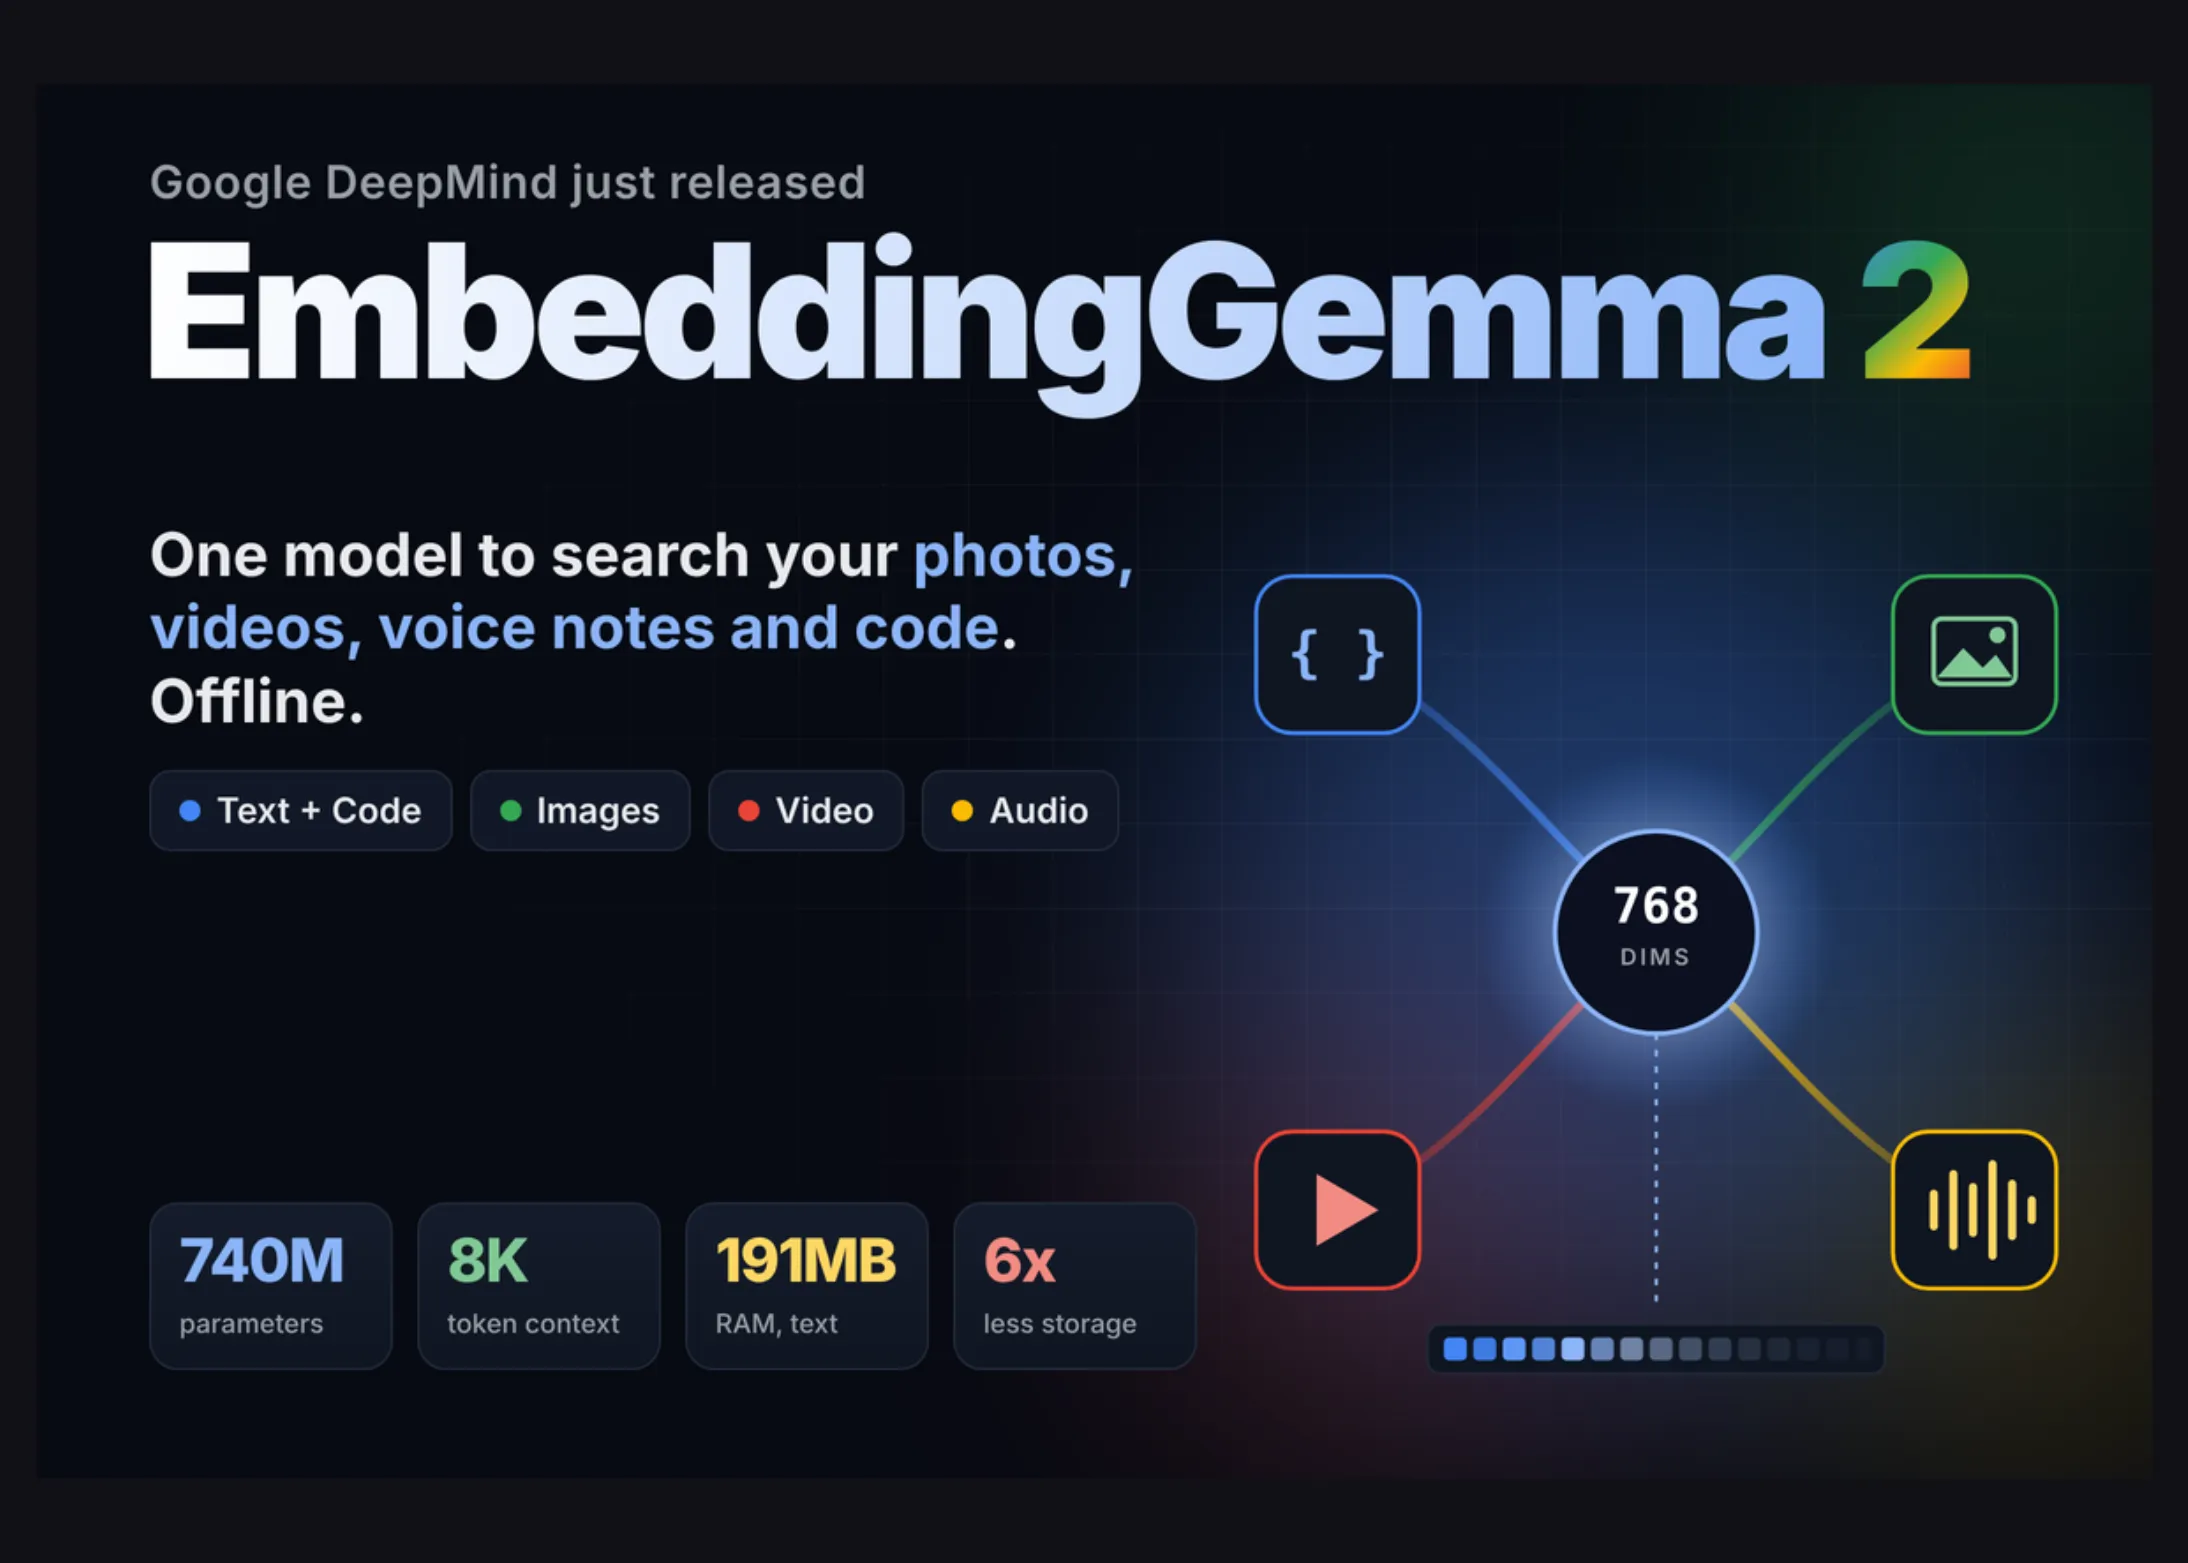
O grande avanço do EmbeddingGemma 2 é ser multimodal, ou seja, capaz de lidar com mais de um tipo de conteúdo ao mesmo tempo. A versão anterior trabalhava basicamente com texto. Esta nova versão coloca código, imagens, vídeo e áudio no mesmo espaço de representação.
Na prática, isso abre possibilidades que antes exigiam vários modelos diferentes. Com o EmbeddingGemma 2 multimodal, você pode achar um clipe de vídeo específico a partir de uma nota de voz, ou buscar em horas de áudio usando um texto. Tudo isso é processado por um único modelo.
O modelo tem 740 milhões de parâmetros e foi construído sobre a arquitetura Gemma 4. Para comparação, é considerado um dos modelos multimodais de embeddings mais fortes com menos de um bilhão de parâmetros. Ele é distribuído sob a licença Apache 2.0, o que permite uso comercial sem as amarras de licenças mais restritivas.
Como funciona por dentro, em linguagem simples
O EmbeddingGemma 2 é modular por design. Isso significa que ele pode ser montado em partes, conforme a sua necessidade.
Para quem só trabalha com texto, basta uma parte de cerca de 270 milhões de parâmetros. Se você quiser adicionar visão, há um codificador de imagens com cerca de 170 milhões de parâmetros. Para áudio, existe um codificador com cerca de 300 milhões. Você usa só o que precisa, o que economiza espaço e processamento.
Há ainda um recurso chamado Matryoshka Representation Learning, que permite cortar os vetores de saída de 768 dimensões para 512, 256 ou 128. Na prática, isso reduz o espaço necessário para armazenar os dados, chegando a economizar até seis vezes em um banco de vetores local. É como poder guardar a mesma informação em um formato mais enxuto quando o espaço é apertado.
Embeddings no dispositivo: por que isso importa
Rodar embeddings no dispositivo, em vez de na nuvem, muda duas coisas importantes: privacidade e velocidade.
Em termos de privacidade, os dados não saem do aparelho. Se você indexa suas fotos, seus áudios ou seus documentos com uma ferramenta local, nada disso precisa ir para um servidor. Para quem trabalha com informações sensíveis, essa diferença pesa muito.
Em termos de velocidade, não há ida e volta até a nuvem. A resposta chega na hora, mesmo sem internet. Isso é essencial em apps que precisam reagir rápido, como um buscador interno ou um assistente que sugere conteúdo enquanto você digita.
E o modelo foi otimizado para caber em aparelhos comuns. Com quantização, em um Google Pixel 11 Pro, a versão só de texto exige cerca de 191 MB de memória ativa, enquanto a versão multimodal completa pede cerca de 567 MB. São números realistas para um celular moderno, o que torna a ideia de embeddings no dispositivo viável de verdade.
Onde você encontra isso no dia a dia
Você pode não ver o EmbeddingGemma 2 diretamente, mas o tipo de tecnologia que ele representa já aparece em vários apps. Aplicativos que organizam fotos por assunto usam embeddings de imagem. Assistentes que entendem o que você quer mesmo sem as palavras exatas usam embeddings de texto.
Aplicativos de anotação que encontram uma nota esquecida a partir de uma ideia vaga também dependem disso. Ferramentas de busca em bibliotecas pessoais de áudio, como gravações de reuniões, fazem o mesmo. Todos esses casos se beneficiam de um modelo multimodal que roda no próprio aparelho.
A grande diferença em relação ao EmbeddingGemma 2 é juntar todas essas capacidades em um só modelo, aberto e leve o suficiente para rodar localmente. Antes, isso costumava exigir serviços na nuvem ou modelos pesados demais para um celular.
Os benefícios de ter um modelo aberto e leve
O primeiro benefício é o custo. Como o modelo roda no aparelho, você não paga por chamadas de nuvem. Para desenvolvedores, isso reduz a conta de infraestrutura e permite oferecer recursos avançados sem repassar custo ao usuário.
O segundo é o controle. Por ser aberto, o modelo pode ser ajustado e adaptado para necessidades específicas, sem depender de um serviço proprietário. Isso dá liberdade para quem quer construir produtos próprios em cima dele.
O terceiro é o desempenho em dispositivos modestos. Graças ao design modular e à quantização, ele roda em aparelhos que não são de ponta, o que democratiza o acesso a recursos de busca inteligente. Não é preciso um servidor caro para ter uma experiência decente.
Por fim, o modelo tem uma janela de contexto de 8 mil tokens, quatro vezes maior que a versão anterior. Isso permite processar até cerca de 5,5 minutos de áudio, 29 imagens ou 58 quadros de vídeo de uma vez, o que amplia bastante o tipo de conteúdo que dá para indexar localmente.
As limitações que você deve conhecer
Nem tudo é vantagem, e é honesto apontar os limites. O EmbeddingGemma 2 não é um modelo de conversa. Ele não responde perguntas nem gera texto. Ele só transforma conteúdo em representações numéricas, o que significa que precisa de outro sistema por cima para virar um produto útil.
O tamanho ainda é um fator. Mesmo sendo leve para um modelo multimodal, ele ocupa centenas de megabytes na versão completa. Em aparelhos com pouco armazenamento, isso pode pesar, especialmente se somado a outros apps.
Há também a questão da qualidade local. Rodar no aparelho significa abrir mão de parte da capacidade de um servidor potente. Para tarefas muito complexas, um modelo maior na nuvem ainda pode entregar resultados melhores. O EmbeddingGemma 2 é um equilíbrio entre desempenho, privacidade e custo, não um substituto universal.
Vale lembrar que, como o modelo é voltado para desenvolvedores, o usuário comum raramente vai interagir com ele diretamente. O impacto chega por meio dos apps que o adotarem, e isso leva tempo.
Comparando com a abordagem na nuvem
A comparação mais útil é com os serviços de embedding na nuvem. Nessa abordagem, os dados vão para um servidor, são processados e voltam como resultado. Isso pode ser vantajoso quando você precisa de um modelo gigante ou de atualizações constantes sem se preocupar com o aparelho.
O EmbeddingGemma 2 inverte essa lógica. Ele prioriza o que acontece no aparelho, com privacidade e resposta imediata. Para apps de uso pessoal, isso costuma ser melhor. Para grandes sistemas corporativos, talvez a nuvem ainda faça mais sentido.
O ideal é escolher conforme o caso. Se o dado é sensível ou precisa de resposta instantânea, o modelo local brilha. Se o volume é enorme e a precisão máxima importa mais que tudo, a nuvem pode ser o caminho. Não existe resposta única, e sim o encaixe certo para cada projeto.
Para quem quer experimentar, o caminho mais prático é baixar um app que já use essa tecnologia de busca local em vez de tentar instalar o modelo por conta própria, o que exige conhecimento de programação. Ao baixar aplicativos, prefira sempre as lojas oficiais, para garantir arquivos íntegros e seguros.
Vale conferir a compatibilidade antes de adotar, já que nem todo aparelho ou framework oferece o mesmo suporte, e manter seus dados protegidos com as práticas de segurança recomendadas pelo fabricante.
O EmbeddingGemma 2 mostra para onde a IA no celular está indo: mais inteligência, mais privacidade e menos dependência da nuvem. Se você é desenvolvedor, vale explorar o modelo para busca local e sistemas de recomendação. Se você é usuário, o benefício chegará por meio dos apps que adotarem essa tecnologia. Fique atento aos lançamentos que usam embeddings no dispositivo, porque a tendência é que esse tipo de recurso apareça cada vez mais nos aplicativos do dia a dia.
 NEWS
 REVIEWS
 HOWTO