EmbeddingGemma 2: Modelo de embedding multimodal para tu móvil
2026-10-08
EmbeddingGemma 2 es el modelo de embedding multimodal de Google para el dispositivo. Explicamos qué es, cómo funciona y por qué mejora la búsqueda semántica en Android.
Los modelos de IA que corren en el teléfono suelen ser los que generan texto o imágenes, casi nunca los que buscan dentro de tus archivos. EmbeddingGemma 2 cambia eso: es un modelo de embedding diseñado para convertir texto, imágenes, audio y vídeo en representaciones que tu dispositivo puede comparar sin enviar nada a la nube. El 6 de octubre de 2026, Google DeepMind lo liberó como modelo abierto, y su impacto va más allá del terreno técnico.
Si alguna vez has buscado una foto con una frase, o has querido encontrar un fragmento concreto dentro de una grabación larga, ya conoces el problema que este modelo resuelve. La diferencia es que ahora puede hacerse en local, con latencia mínima y sin que los datos salgan del teléfono. Veamos qué es exactamente y por qué merece atención aunque no escribas código.
Qué es EmbeddingGemma 2 y por qué no es un chatbot
Un modelo de embedding no genera respuestas: traduce contenido a una lista de números, un vector, que representa su significado. Dos cosas parecidas acaban con vectores parecidos, y comparando esos vectores se puede buscar por sentido y no solo por palabras exactas. Esa es la base de la búsqueda semántica, y es lo que hace que buscar "recetas rápidas" encuentre un documento que dice "comidas en cinco minutos". Cuando se habla de un modelo de embedding google para el dispositivo, a eso se refiere: piezas que convierten significado en números comparables.
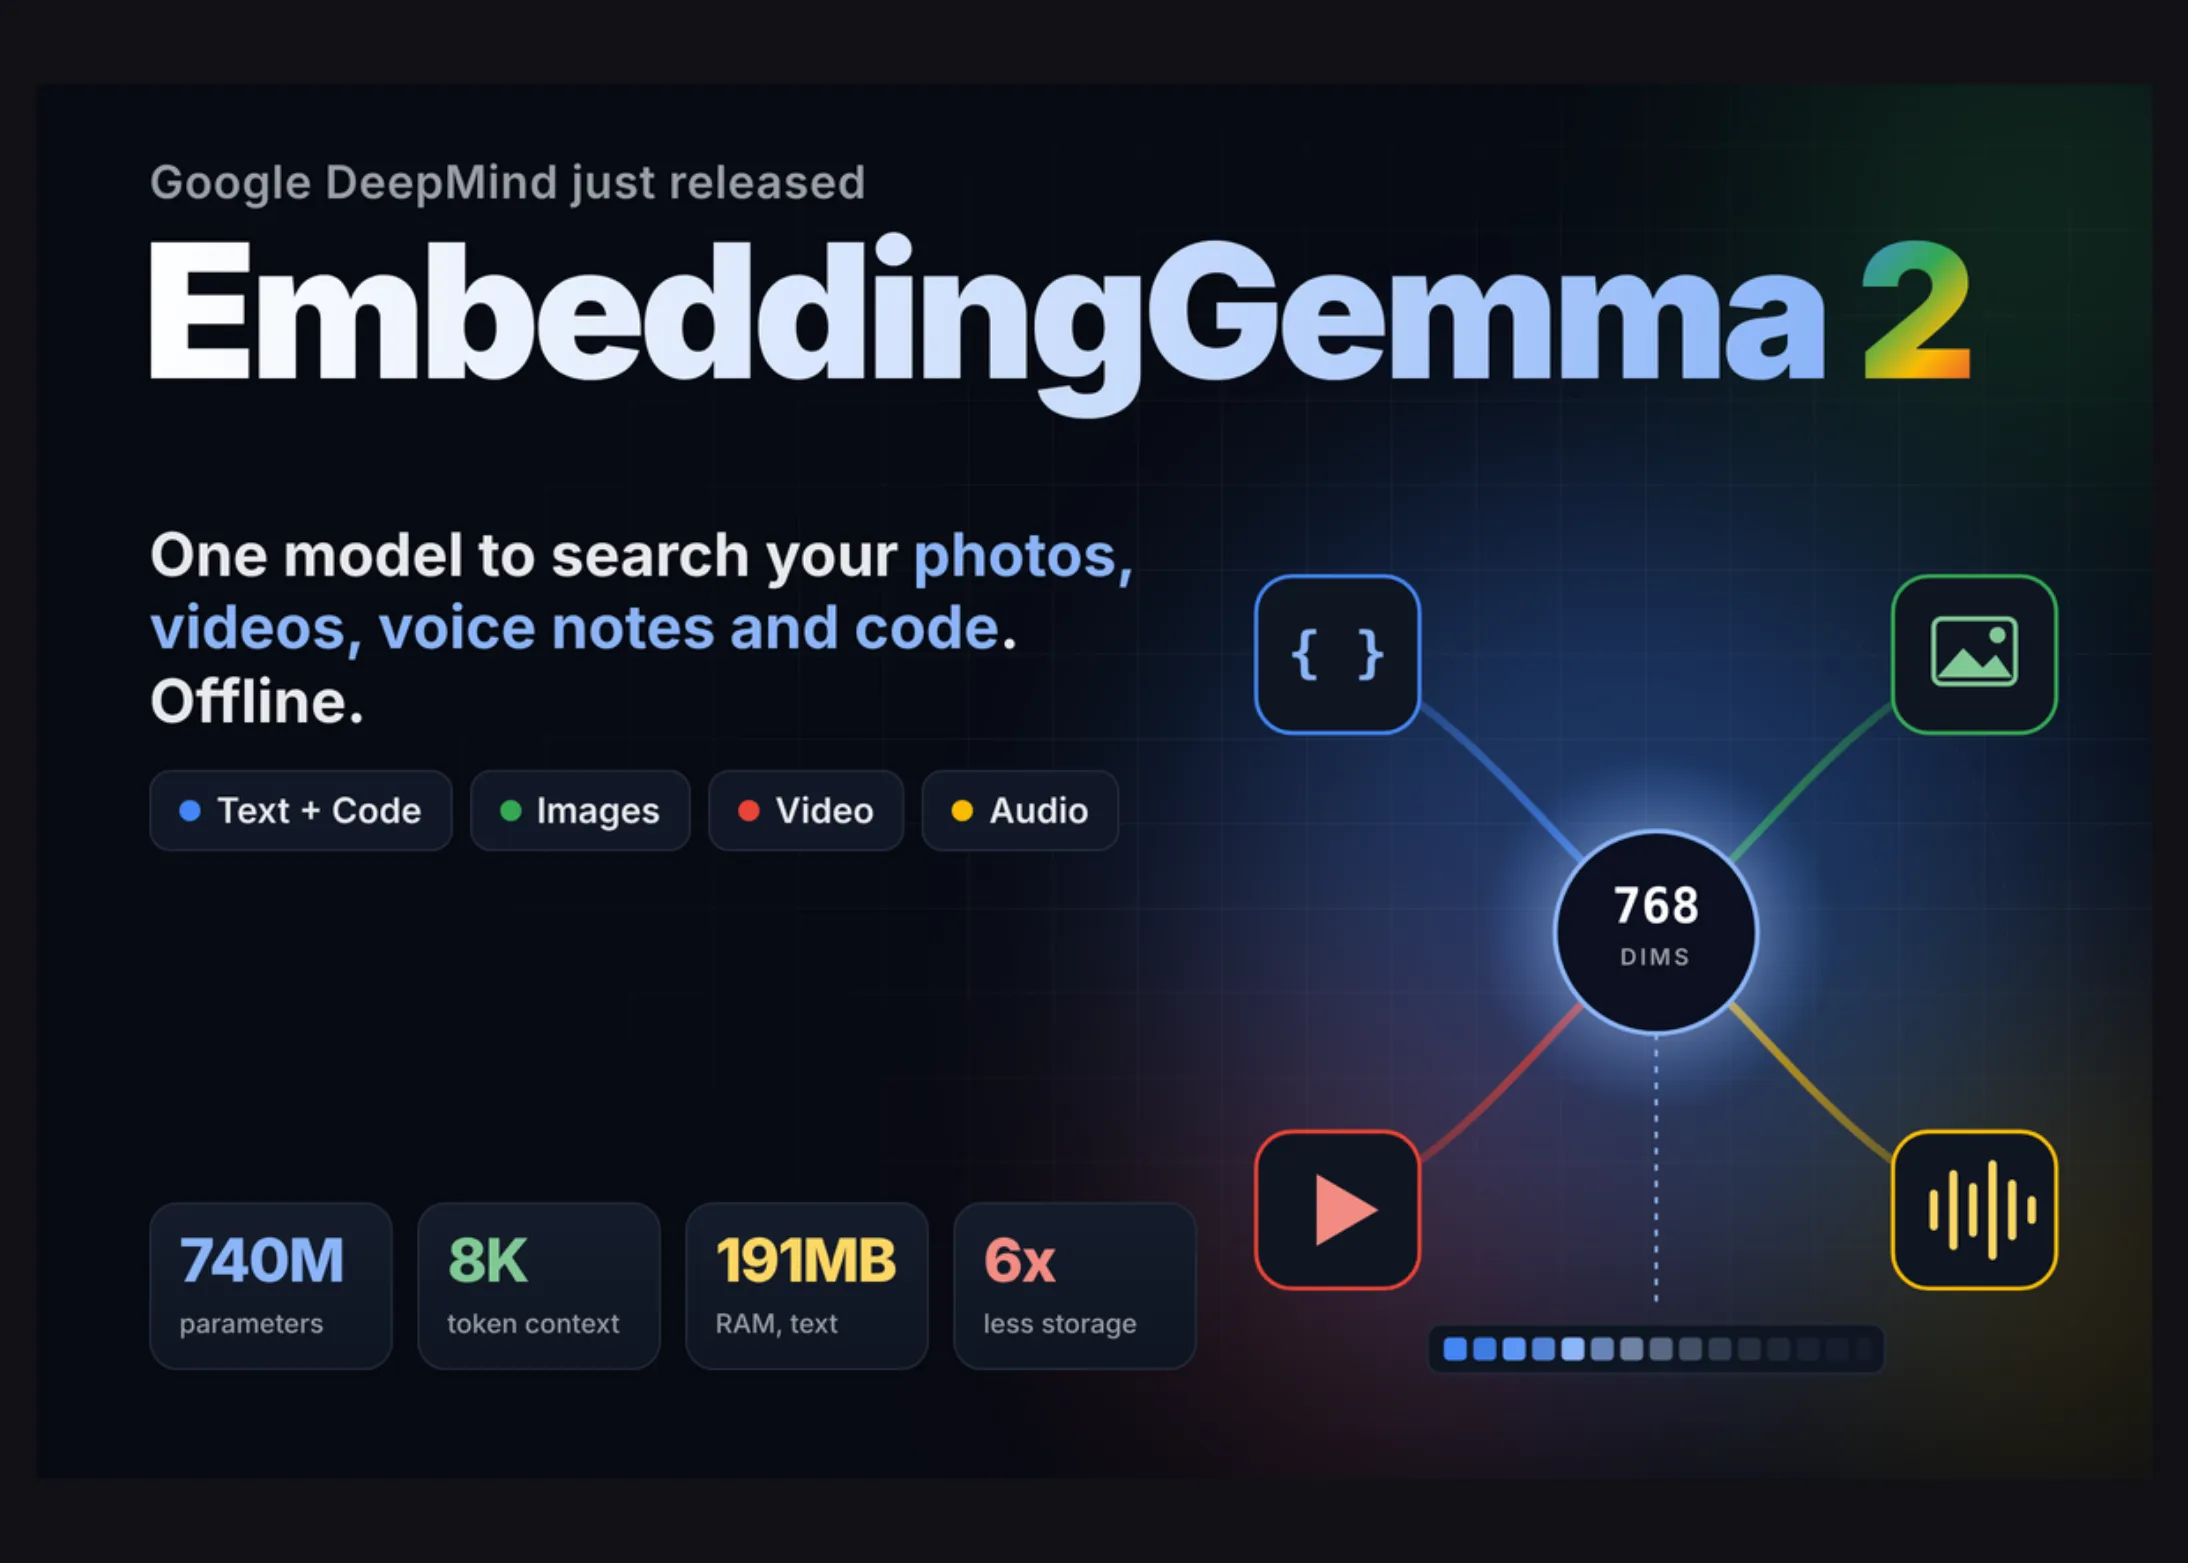
EmbeddingGemma 2 lleva esa idea un paso más allá al ser multimodal. La versión anterior solo trabajaba con texto; esta unifica texto, imágenes, audio y vídeo en un mismo espacio de representaciones. Eso permite cruzar modalidades: encontrar el clip de vídeo que corresponde a una nota de voz, o localizar en grabaciones de horas la parte que responde a una consulta escrita.
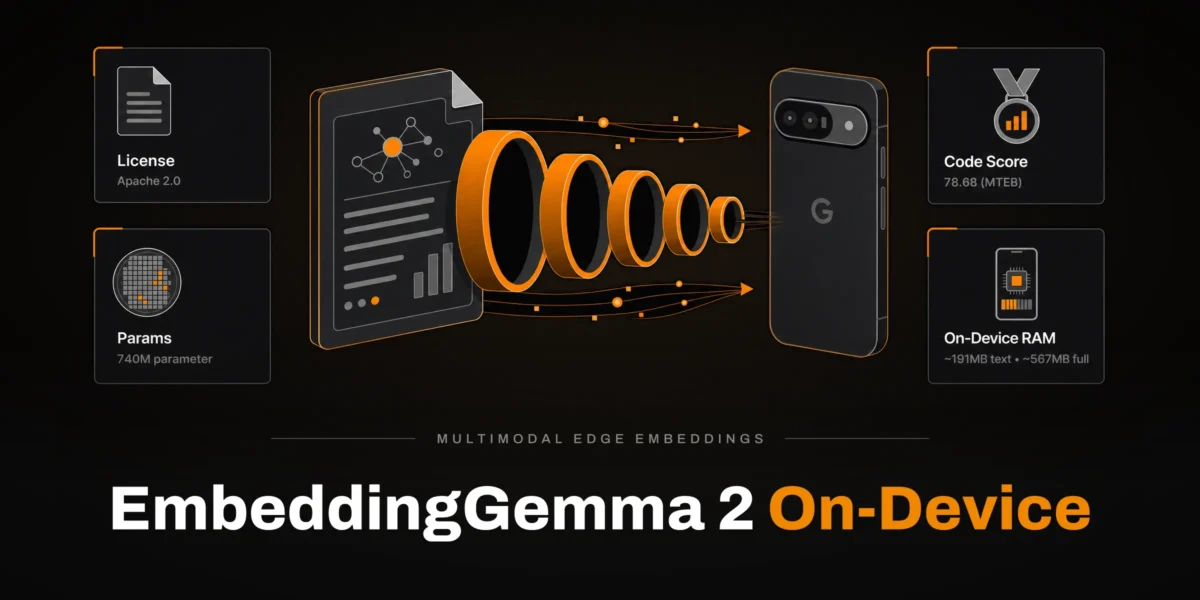
Google insiste en tres características. Es el mejor de su tamaño entre los modelos multimodales de menos de mil millones de parámetros, según benchmarks como MTEB Code y MAEB. Es modular, porque puede funcionar solo con texto usando 270 millones de parámetros y crecer hasta 740 millones con el modelo completo. Y es abierto, con licencia Apache 2.0, lo que permite usarlo comercialmente sin grandes restricciones.
EmbeddingGemma multimodal: cómo funciona en el dispositivo
El detalle clave es dónde se ejecuta. EmbeddingGemma 2 está pensado para correr en hardware de consumo, como teléfonos y portátiles, usando herramientas como MediaPipe y LiteRT. Eso significa que la búsqueda y la clasificación ocurren dentro del dispositivo, sin necesidad de enviar los datos a un servidor.
La arquitectura modular ayuda a ajustar el coste. Si tu caso de uso solo necesita texto, el modelo funciona con una fracción de sus parámetros, lo que reduce el consumo de memoria. Si necesitas imágenes y audio, se carga la versión completa. Esa flexibilidad importa en móvil, donde la RAM y la batería son recursos limitados.
Otra ventaja de correr en local es la privacidad. Al no enviar el contenido a la nube, no hay riesgo de que tus fotos, notas de voz o documentos salgan del dispositivo para ser procesados. Para quien maneja información sensible, el modelo abre la puerta a funciones de búsqueda inteligente que antes exigían renunciar a esa privacidad.
Embeddings en el dispositivo: ejemplos reales en Android
- El primer uso natural es la búsqueda en la galería. Con un modelo multimodal, puedes describir lo que buscas y encontrar la foto correspondiente aunque no tenga etiquetas ni nombre. Buscar "el perro en la playa" deja de depender de metadatos y pasa a basarse en el contenido real de la imagen.
- El segundo uso es la búsqueda dentro de audio. Puedes localizar un momento concreto en una grabación larga escribiendo lo que se dijo allí. Es útil para reuniones, apuntes de voz o cualquier archivo donde encontrar un fragmento a mano sea inviable. El modelo convierte la consulta y el audio al mismo espacio de vectores y encuentra la coincidencia.
- El tercero es la búsqueda semantica movil dentro de apps. Una aplicación de notas puede encontrar la entrada relevante aunque uses otras palabras; una de correo puede agrupar mensajes por tema aunque no compartan términos. Al correr en el dispositivo, todas esas funciones responden al instante y funcionan incluso sin conexión.
Ventajas y límites de un modelo ia local android
Ventajas:
- Control. Todo se procesa en el teléfono, así que la privacidad está garantizada y la latencia es mínima. A diferencia de los asistentes que dependen de la nube, un modelo ia local android funciona aunque no haya conexión, algo decisivo en un avión, el metro o una zona sin cobertura.
- Coste. Usar un modelo en el dispositivo no genera facturas por consulta, a diferencia de las API en la nube. Para apps que hacen muchas búsquedas pequeñas, esa diferencia se traduce en un ahorro considerable y en un diseño más predecible.
Límites:
- Tamaño. Con 740 millones de parámetros, el modelo completo ocupa espacio y consume memoria, así que no todos los teléfonos podrán ejecutarlo con la misma soltura. Los dispositivos de gama baja probablemente se limiten a la versión de texto o queden fuera del alcance.
- Calidad frente a modelos mayores. EmbeddingGemma 2 es excelente para su tamaño, pero no compite con modelos multitudinarios en la nube en tareas muy complejas. Para búsqueda y clasificación cotidianas va sobrado; para razonamiento profundo sobre grandes volúmenes, sigue habiendo alternativas más potentes.
Qué significa para el futuro de la IA en Android
El lanzamiento encaja en una tendencia clara: llevar la IA al dispositivo en lugar de depender siempre de la nube. Al ser abierto y modular, EmbeddingGemma 2 da a los desarrolladores una pieza lista para construir búsqueda inteligente en apps sin montar infraestructura propia. Eso baja el umbral para que funciones avanzadas lleguen a aplicaciones pequeñas.
Para el usuario, la consecuencia es concreta. Las apps que usas a diario pueden volverse más listas sin pedir más datos a cambio. Buscar en tus propias fotos, notas o grabaciones por significado, y no por coincidencia exacta, deja de ser una función exclusiva de servicios en la nube.
Queda por ver cuánto tarda esa promesa en llegar a las apps que usas. El modelo es la materia prima, pero hace falta que los desarrolladores lo integren. Los primeros pasos ya se ven en las herramientas de Google, y el resto depende de la comunidad.
Conclusión: piezas para una IA que vive en tu teléfono
EmbeddingGemma 2 no es un chatbot ni una app, sino una pieza de infraestructura que hace posible algo más útil: buscar por significado dentro de tu propio dispositivo. Su combinación de tamaño reducido, licencia abierta y capacidad multimodal lo coloca como una de las bases más prometedoras para la IA local en Android.
Si eres desarrollador, el modelo ya está disponible para probar. Si eres usuario, la mejor señal es indirecta: las próximas versiones de tus apps favoritas podrán buscar mejor sin subir tus datos a ningún sitio, algo que conviene tener presente al actualizar. Descarga las actualizaciones desde APKPure cuando lleguen, revisa los permisos que piden las apps y guarda tu información donde no tenga que salir del teléfono para ser útil.
 NEWS
 REVIEWS
 HOWTO