Modelos de Liquid AI open d1: d1-3B y d1-omni-600M
2026-10-08
Liquid AI open d1 libera dos modelos abiertos que deciden en lugar de escribir. Explicamos qué es el d1-3B, el d1-omni-600M y por qué el modelo de decisión liquid ai corre en el borde.
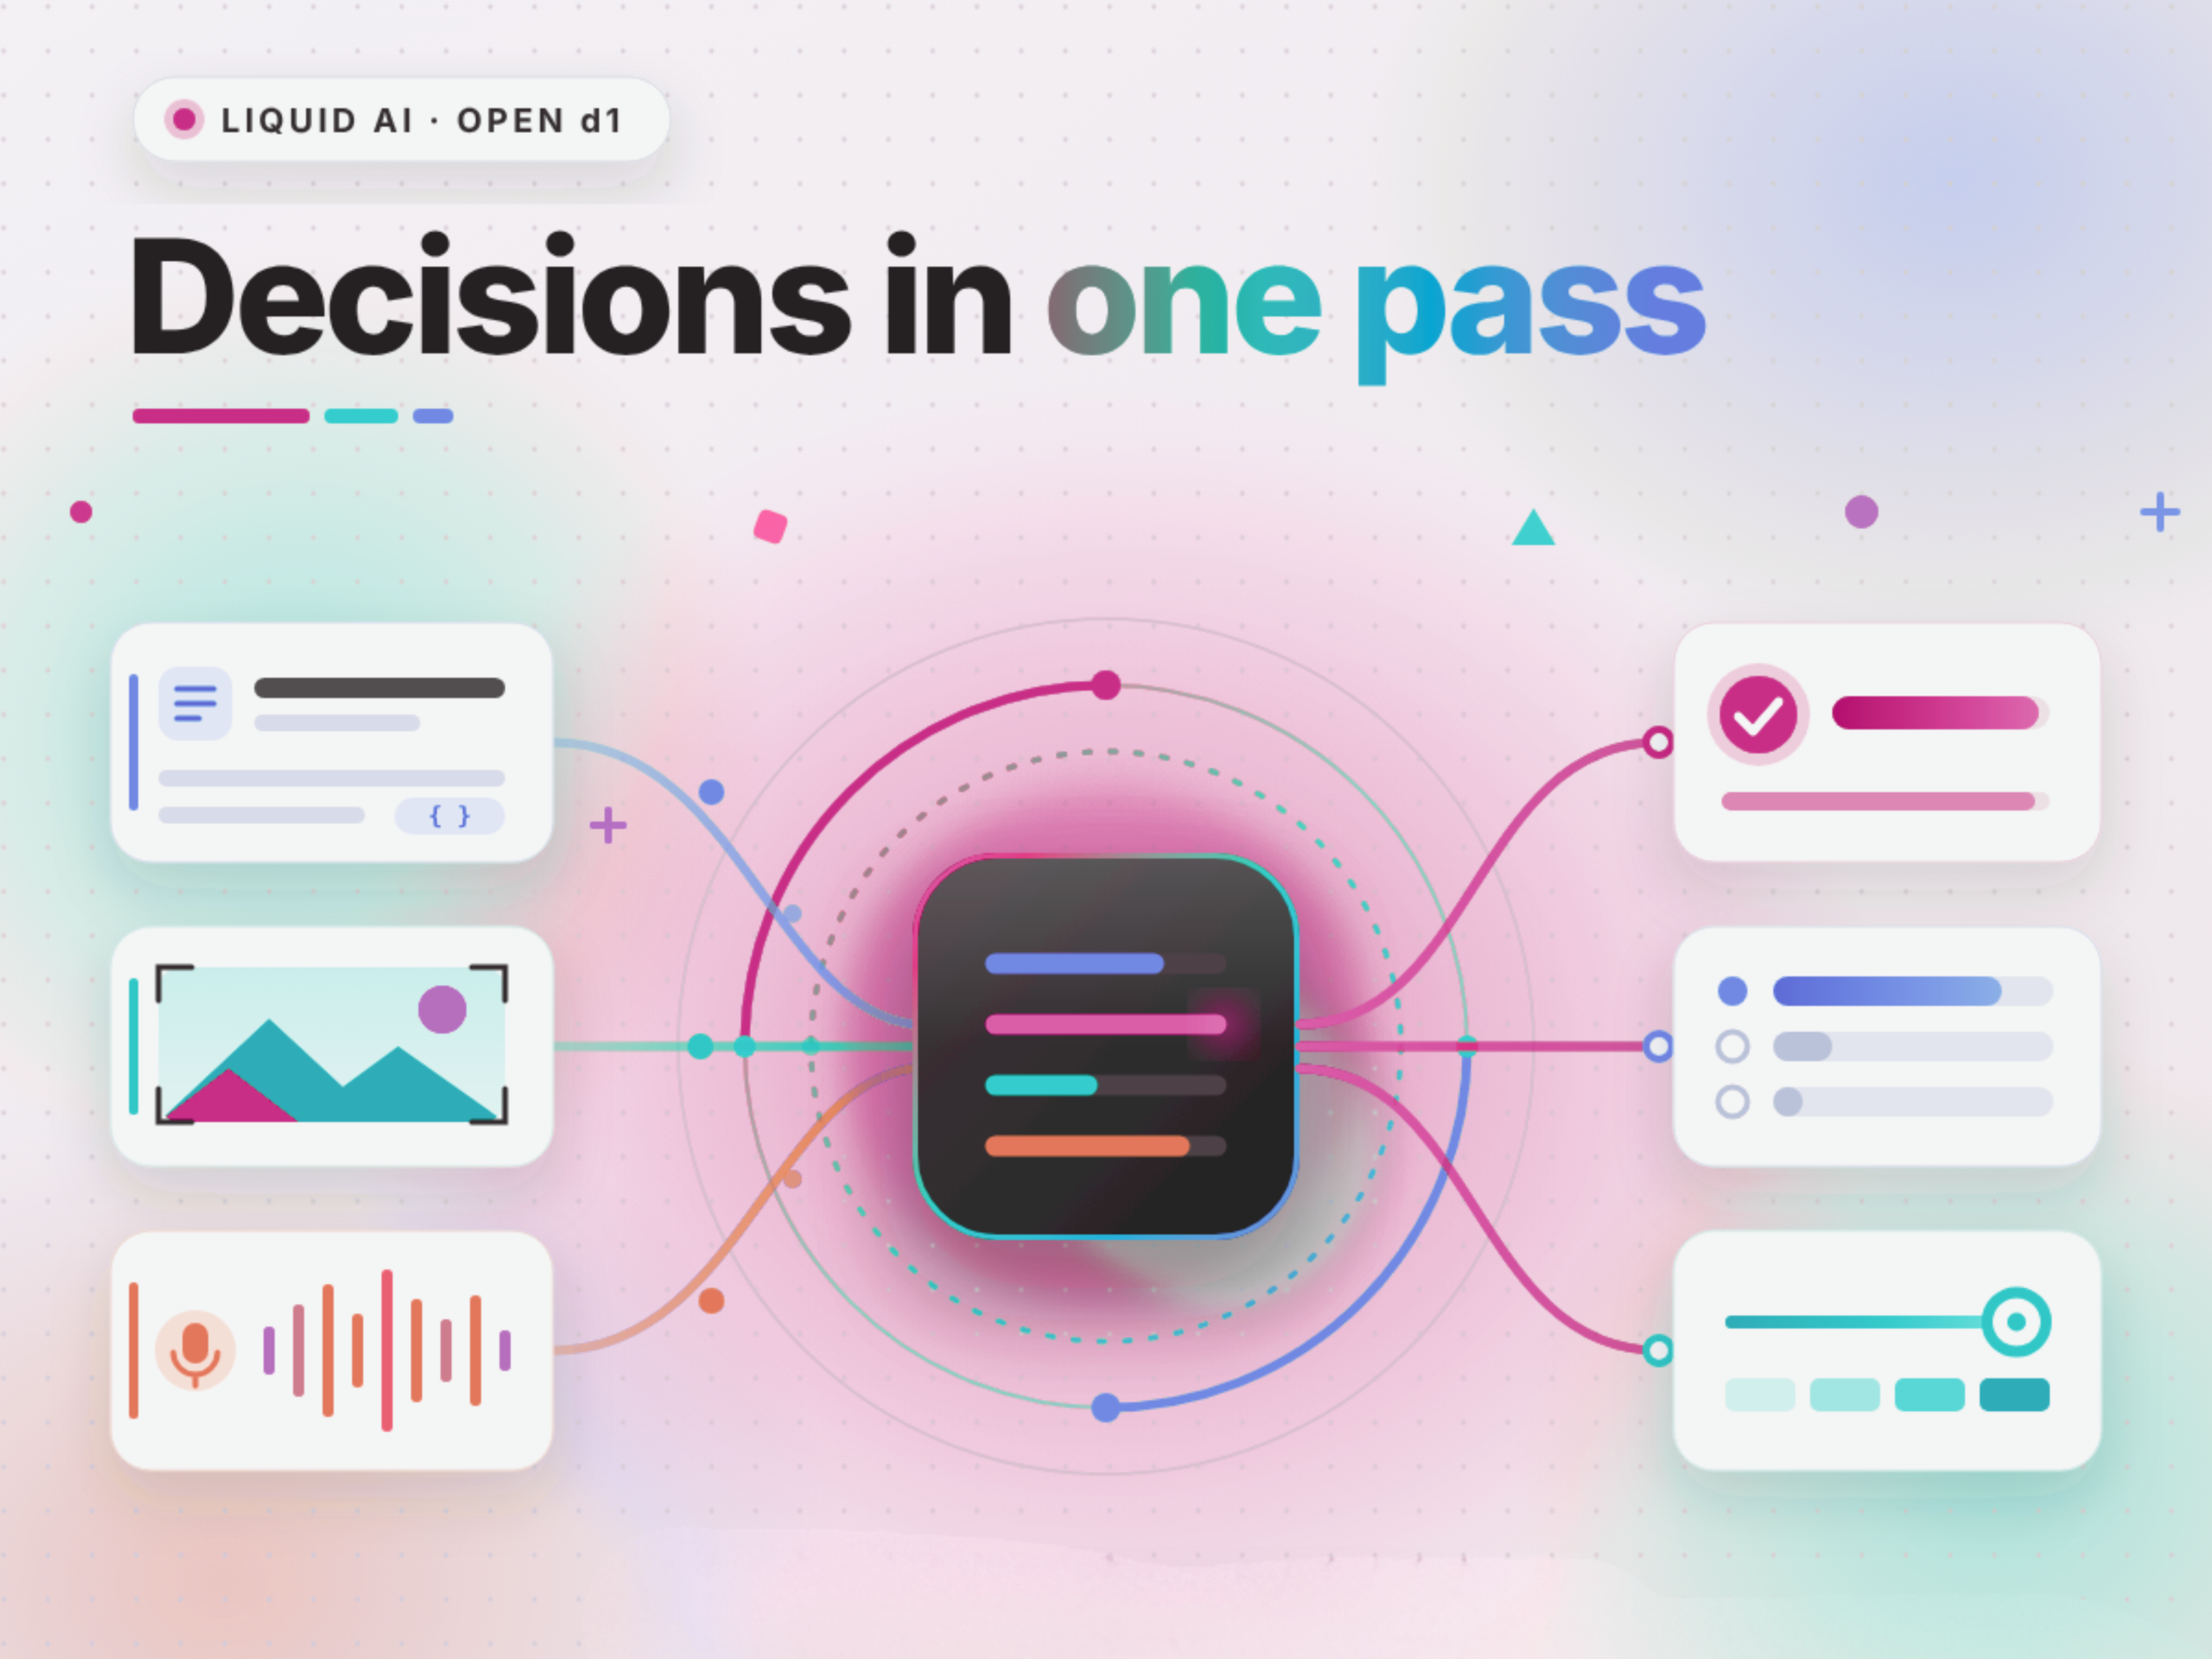
Casi todos los modelos de IA que conoces tienen la misma manía: escriben. Responden con frases, una palabra detrás de otra, aunque la pregunta solo exija un sí o un no. Liquid AI propone algo distinto con Liquid AI open d1, una familia de modelos que no escribe: decide. Si eso te suena abstracto, piensa en la diferencia entre un asistente que te explica una decisión y un sistema que simplemente te da la respuesta y se calla.
El 7 de octubre de 2026, la compañía liberó dos modelos abiertos de esa familia: d1-3B y d1-omni-600M. Ambos están disponibles en Hugging Face, con pesos abiertos. Y ambos apuntan al mismo hueco: tareas donde lo que necesitas es una decisión rápida y barata, no un párrafo. El modelo de decisión liquid ai es la apuesta de la compañía por ese nicho.
Qué es un modelo de decisión frente a un modelo que genera
La diferencia está en la salida. Un modelo generativo produce tokens: texto que se forma paso a paso. Un modelo de decisión, en cambio, recibe datos y una pregunta, los lee en una sola pasada hacia adelante y devuelve una respuesta. No hay texto intermedio, no hay redacción. Solo el veredicto.
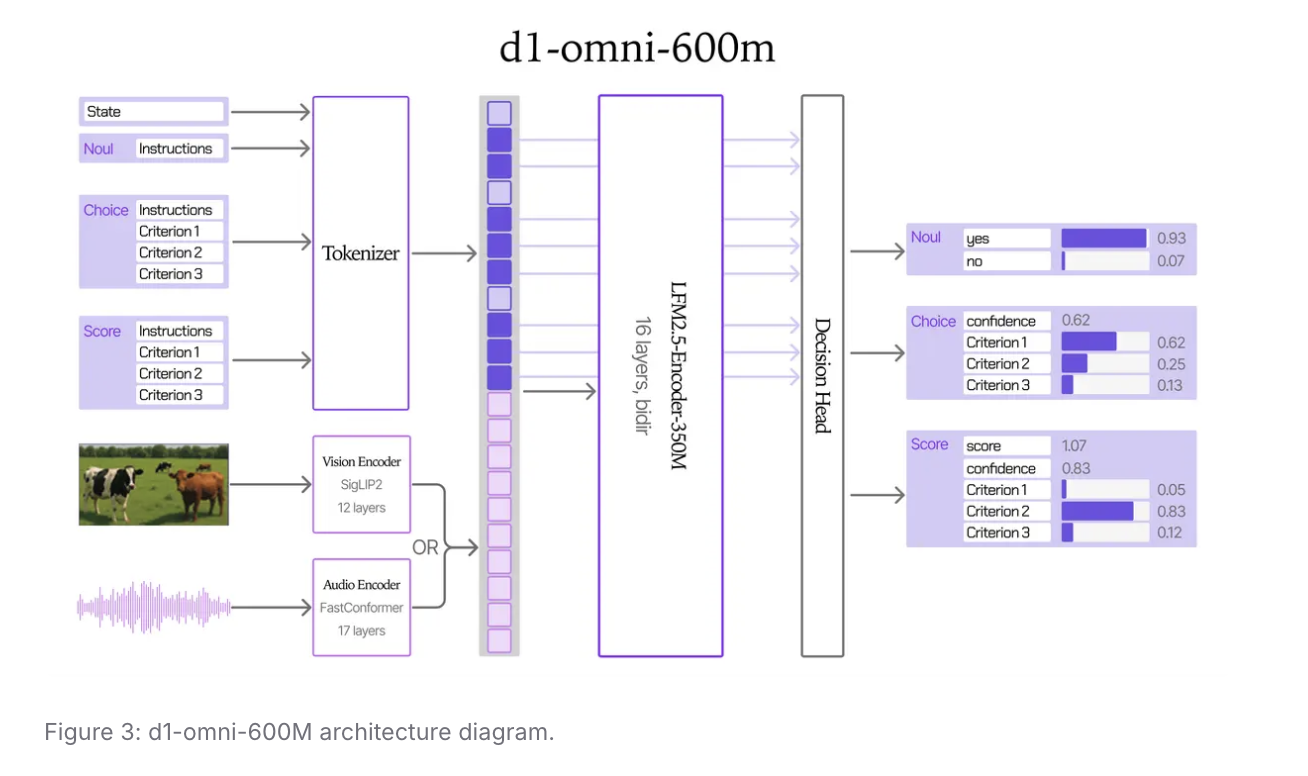
Liquid AI plantea tres tipos de pregunta para sus modelos. Está la de sí o no, que devuelve una probabilidad entre 0 y 1. Está la de elección, que elige una etiqueta entre varias y da una probabilidad por etiqueta. Y está la de puntuación, que sitúa un valor en una escala. Una misma petición puede preguntar varias cosas sobre el mismo estado, lo que ahorra tokens de entrada.
Ese diseño explica por qué los d1 son tan rápidos. Al no generar texto, evitan la parte más costosa de un modelo de lenguaje. En lugar de construir una frase larga para decir "sí", devuelven el "sí" directamente. Para tareas repetitivas, esa diferencia se nota en el tiempo y en el coste.
Liquid AI open d1: qué traen el d1-3B y el d1-omni-600M
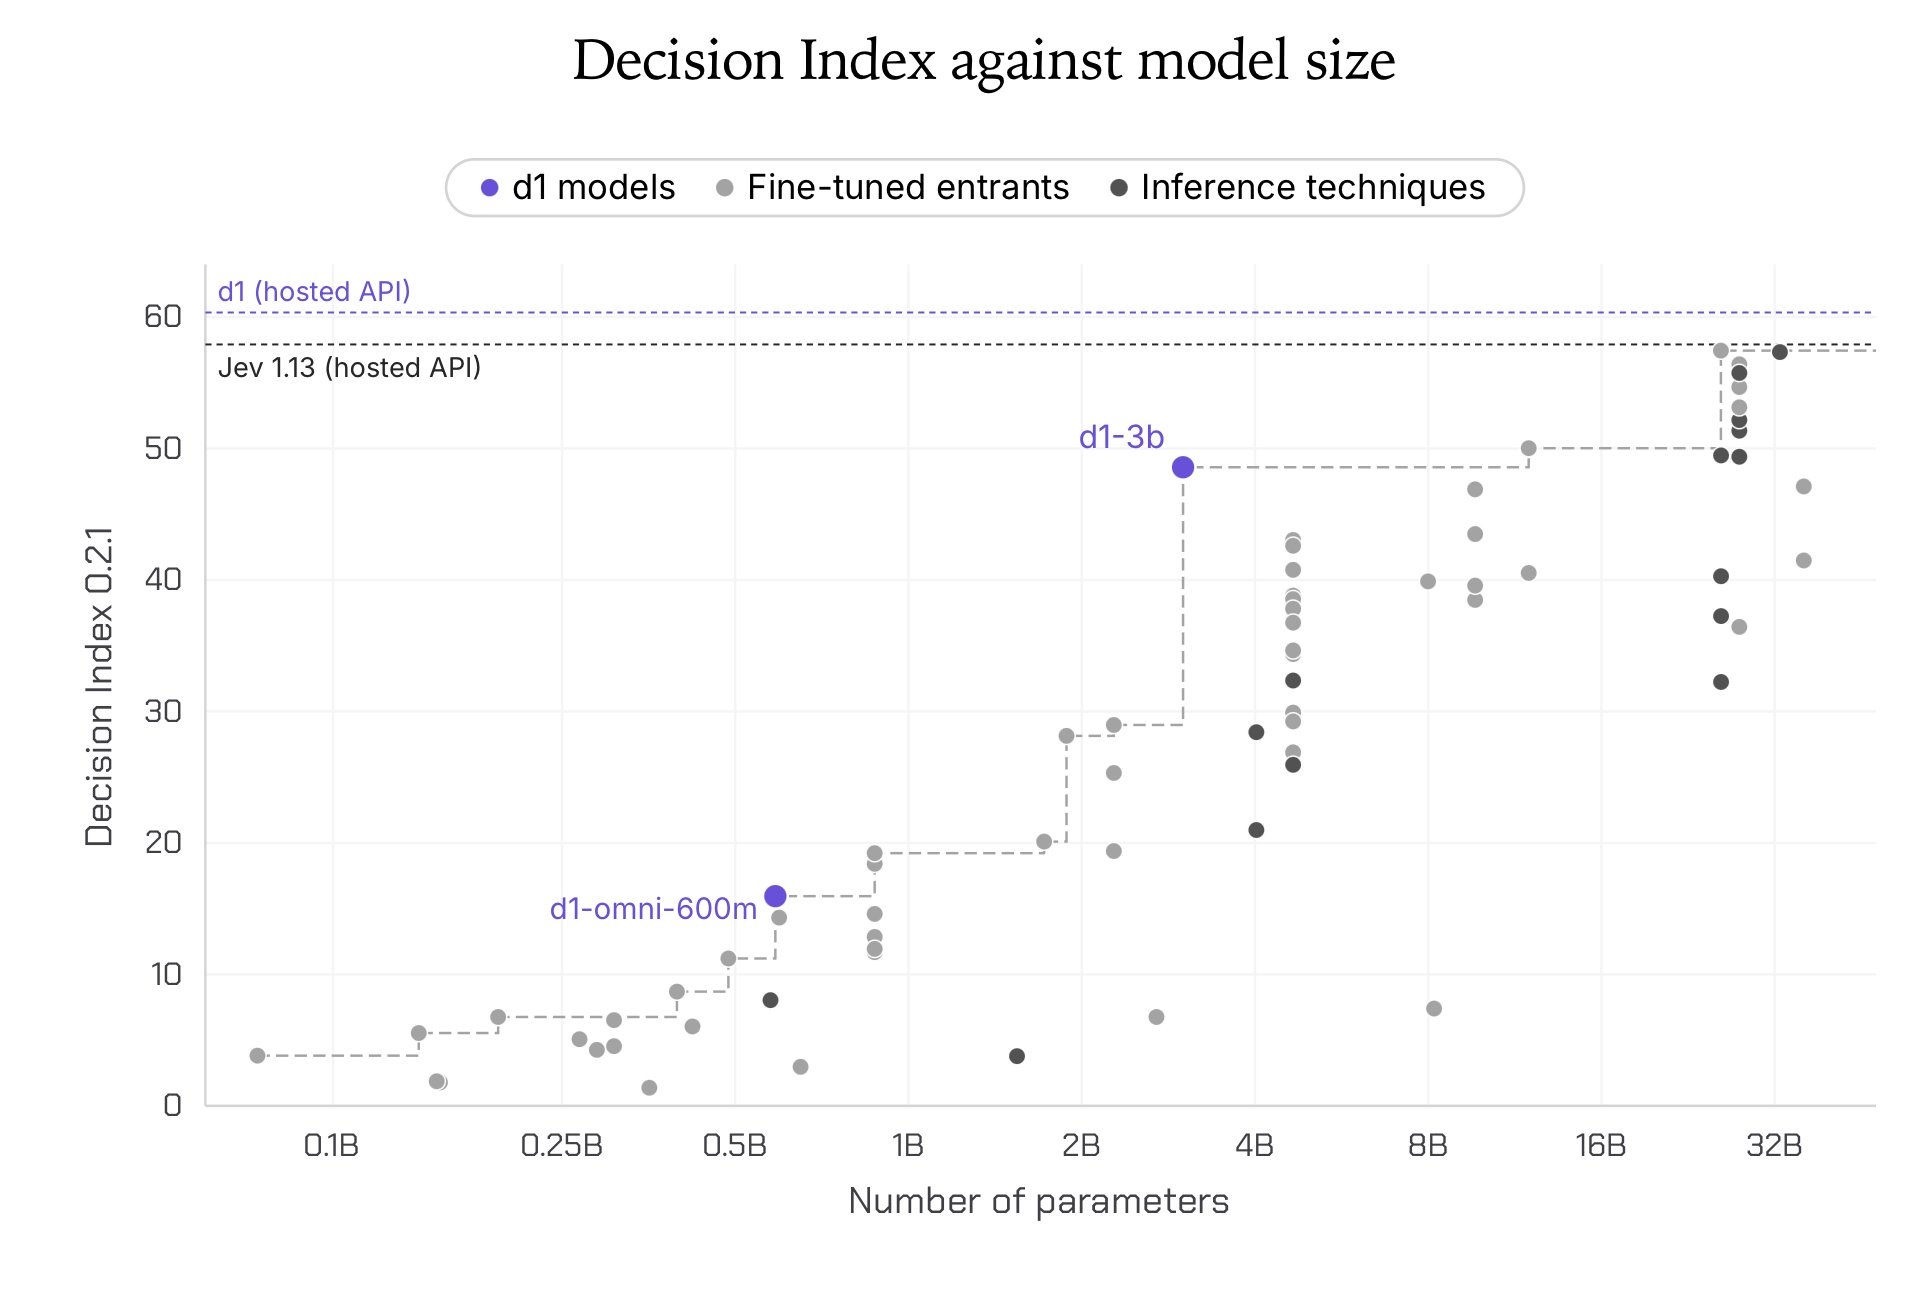
Los dos modelos abiertos llegan con perfiles distintos. El d1-3B es el mayor y el más capaz en texto. Según Liquid AI, obtiene 48,57 en el Decision Index v0.2.1, por delante de todos los modelos por debajo de 10.000 millones de parámetros y a la altura del Decider 35B-A3B, un modelo doce veces más grande. Es una cifra que sitúa al d1-3B como referencia en su franja de tamaño.
El d1-omni-600M es la apuesta multimodal. Es el primer checkpoint experimental de la compañía con visión y audio, además de texto. Maneja texto e imagen, o texto y audio, y obtiene 15,95 en el mismo índice. Es un modelo mucho más pequeño, pensado para probar qué se puede hacer con las tres modalidades en el borde.
La palabra clave del anuncio es "open". Ambos se publican con pesos abiertos en Hugging Face y documentación para ejecutarlos localmente. Eso significa que puedes descargarlos y correrlos en tu propio hardware, sin depender de una API en la nube.
Cómo se entrenaron y por qué importan los detalles
El d1-3B no parte de cero. Se entrenó a partir de LFM2.5-VL-3B, el modelo de visión y lenguaje de Liquid AI, que acepta texto e imágenes. Para mejorarlo, la compañía promedió los pesos de LFM2.5-2.6B con la parte de texto de LFM2.5-VL-3B, y luego ajustó varios checkpoints con semillas y mezclas de datos distintas antes de fusionarlos.
Liquid AI cuenta un detalle útil: entrenar con entradas largas, barajar las opciones de respuesta y corregir atajos en los datos dio más resultado que técnicas más sofisticadas. Es un recordatorio de que, en modelos pequeños, los datos bien curados pesan más que los trucos de arquitectura.
El d1-omni-600M sigue otro camino. Se entrenó desde LFM2.5-Encoder-350M, un codificador bidireccional. Primero se ajustó en tareas de decisión, y después se le añadieron audio y visión por etapas. Para el audio se entrenó un codificador FastConformer con un adaptador; para la visión se reutilizó el codificador de LFM2.5-VL-450M con adaptador y ajustes LoRA. Al final, se ajustó el modelo completo y se promediaron los pesos.
Qué rendimiento ofrecen y dónde corren
En texto, el d1-3B lidera con una media de 82,9 en siete pruebas públicas que cubren comprensión lectora, detección de toxicidad, clasificación de intención, preguntas médicas y comprensión entre idiomas. Supera al Decider 4B (81,1) en esa media. El d1-omni-600M, más pequeño, se queda en 78,4, un resultado sólido para su tamaño.
El rendimiento en hardware es donde el modelo de decisión liquid ai brilla. El d1-3B responde en 8 milisegundos en una NVIDIA GeForce RTX 4090, en 16 milisegundos en un Jetson AGX Thor y en 26 milisegundos en un Jetson AGX Orin. Incluso el Jetson Orin Nano, el más modesto, lo ejecuta en 50 milisegundos. Son cifras de tiempo real en hardware de borde.
Eso conecta con la filosofía de Liquid AI, que se presenta como una empresa de modelos nativos para el dispositivo. Su promesa es claro: inteligencia para procesadores fuera de los centros de datos, pensada para las limitaciones de latencia, privacidad y hardware del mundo físico.
Para qué sirve un modelo que decide
Liquid AI describe usos que van de la inspección visual a la automatización de decisiones. En el primer caso, el d1 revisa piezas que pasan bajo una cámara y clasifica las buenas y las defectuosas con una precisión del 85 al 97 %, sin haber sido entrenado específicamente para esa tarea. Entiende el trabajo a partir de una descripción breve.
En texto, los ejemplos apuntan a tareas repetitivas. Un filtro inteligente puede convertir el modelo en una función dentro de una consulta de base de datos para decidir si un cliente quiere cancelar, respondiendo sí o no para cada caso. Un buscador de código puede recorrer un repositorio carpeta a carpeta hasta dar con la función que responde a una pregunta.
Otros usos incluyen clasificar documentos en carpetas, operar un sitio web de búsqueda de vuelos a partir de un objetivo en una frase, o comprimir el contexto de un agente de código eliminando la mitad de los tokens sin perder lo necesario. En todos, la ventaja es la misma: sustituir llamadas caras a un modelo de lenguaje cuando la respuesta es una decisión estructurada.
Ventajas y límites que conviene conocer
La ventaja principal es la eficiencia. Un modelo que decide en una sola pasada gasta menos cómputo y responde antes que uno que redacta. Para tareas donde miles de decisiones se toman al día, esa diferencia se traduce en ahorro y en latencia baja.
El límite es el alcance. Estos modelos no conversan ni explican: devuelven una respuesta. Si necesitas redacción, razonamiento largo o creatividad, no son la herramienta. El d1-omni-600M, además, es un checkpoint experimental y su puntuación multimodal es modesta, así que sirve más para explorar que para producción.
También conviene recordar que son modelos pequeños. El d1-3B es líder en su franja, pero no compite con modelos mucho mayores en tareas de razonamiento complejo. Su terreno son las decisiones acotadas y repetidas, no los problemas abiertos.
Conclusión: la IA que responde en vez de redactar
Liquid AI open d1 propone una idea sencilla y útil: separar el acto de decidir del acto de escribir. Con el d1-3B y el d1-omni-600M abiertos en Hugging Face, cualquier desarrollador puede probar un modelo de decisión liquid ai que corre en el borde, en milisegundos y sin enviar datos a la nube.
Si construyes apps con decisiones repetitivas, vale la pena probar el d1-3B en tareas de clasificación y filtrado. Y si te interesa el lado multimodal, el d1-omni-600M es un punto de partida para experimentar. Descarga las herramientas de despliegue, revisa los requisitos de tu hardware y mide si la diferencia de latencia justifica el cambio.
 NEWS
 REVIEWS
 HOWTO