什麼是 Fireworks Ember-1?基於 Kimi K3 的推理模型全解析 2026
2026年09月29日
Ember-1 以 Kimi K3 為底重新訓練,把多餘的推理剪掉,官方數據顯示能省 35% 到 50% 的推理詞元而品質持平。這篇拆解它的原理、表現、適用場景與該注意的限制。
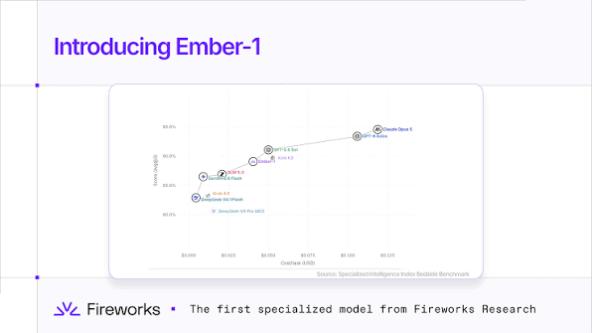
Fireworks AI 在 9 月 27 日把 Ember-1 推上 serverless 平台,這是一個以 Kimi K3 為基礎、主打「推理詞元更省」的模型。官方說法很直接:品質對得上 K3,但完成同一件事用的推理詞元少約 40%。
這個數字為什麼值得在意?因為如果你的工作是靠 AI 自動寫程式、跑 agent,帳單大頭往往不在答案本身,而在模型自言自語的那一長串推理過程。Ember-1 動的正是這一塊。這篇把它的來歷、機制、適用場景與限制講清楚。
Fireworks Ember-1 是什麼
先講定位。Ember-1 不是一個全新從零訓練的通用模型,而是 Fireworks Research 以 Moonshot AI 的 Kimi K3 為底、經過專門訓練後得到的「特化模型」。
Fireworks 對這個 ember-1 模型的描述是:保留 K3 的品質,同時把多餘的推理砍掉。它屬於 Fireworks 一系列特化模型的第一款,後面還會有更多。這也是 Fireworks AI 模型系列第一次把「省推理」當成主打賣點。
可以這樣理解:K3 是一台馬力很足但油門踩很深的車,Ember-1 則是同一具引擎,重新調校過供油曲線,跑同樣的路程少燒一些油。引擎沒換,調校方式換了。這個比喻大致準確,前提是你不把「省油」誤讀成「性能打折」,官方強調的是品質持平。
Kimi K3 推理模型為什麼耗詞元
要懂 Ember-1,先得懂它想解決的問題。
像 Kimi K3 這類推理模型,產生的詞元裡有很大一部分花在內部思考,而不是最後的答案。依 Fireworks 的觀察,這個比例有時超過九成。單次請求這樣已經不便宜,放到多輪的 agent 工作流會更誇張。
關鍵在於:每一輪對話都會把先前的推理重新讀回來。當輪次增加,上下文幾乎以平方速度膨脹,早期那些冗長的推理,會在之後每一次呼叫裡被重新讀取、重新計費。跑得越久,浪費越多。
Fireworks 的實驗得出一個結論:那些推理很多是不必要的,任務根本用不到那麼長。把多出來的剪掉,答案並不受影響。這正是 Ember-1 的出發點。
Fireworks Ember-1 怎麼把詞元省下來
做法不是把模型的推理能力調低,而是訓練它「更會想」。
Fireworks 團隊試過直接降低 K3 的推理強度,結果品質掉太多,行不通。所以要保留品質又省詞元,模型必須學會更有效率地推理,而這需要訓練。他們跑了超過 50 組訓練實驗、200 次以上的評估,還為此開發了新的訓練演算法。
不是所有推理都該砍。有一部分是自我反思:重看一個假設、回應回饋、把結果追溯到早先的決定,這些能幫模型從錯誤裡爬回來。Ember-1 的目標是把這種有用的反思留下,同時把沒在辦事的空轉剪掉。說到底,它追求的是詞元效率,而不是把模型變笨。
訓練資料涵蓋數學、程式、指令遵循、對話、搜尋、工具使用與軟體工程,既有單題,也有長時間互動。訓練全程在 Fireworks 自家的 serverless 訓練平台上跑,沒有用到客戶的資料。
Fireworks Ember-1 的實際表現
數字最能說明問題,但也要看清楚數字的來源。
根據 Fireworks 公布,橫跨七項公開基準與兩家客戶的實際生產流量,K3 的推理可以縮短 35% 到 50%,而準確度沒有犧牲。這個區間比「40%」這個單一數字更完整,40% 大致落在中間。
在 Fireworks 自家的 Specialized Intelligence Index 上,Ember-1 於 Doximity 的 Bedside Bench 設下新的帕雷托前沿,這是涵蓋 500 個臨床案例、由醫師驗證的基準。它是在成本與任務表現的取捨上取得位置,對照的模型包括 GPT-5.6 Sol、GPT-6 Astra 與 Claude Opus 5。
要注意的是,這些基準與數字都由 Fireworks 自己發布。第三方獨立驗證目前還不多,而且模型仍處於 Research Preview 階段,實際表現可能隨版本調整。
Fireworks Ember-1 適合哪些用途
如果你的工作會踩到「長會話 + 高快取」這條線,Ember-1 的吸引力就明顯。
最有感的是 agentic 編碼。當一個任務要來回幾十輪、每輪都重讀上下文,累積的推理重複成本會快速堆高。省下來的推理詞元,直接反映在帳單上。自動化的多步工作流、需要長時間追蹤的工具呼叫,也都屬於這一類。
反過來說,如果只是短問答、單次生成、或不太依賴長上下文的場景,省詞元的效益就有限。模型品質持平,但你本來就沒吃多少推理重複,換過去感受不到差別。
價格方面,Fireworks 的說法是 Ember-1 在同樣價位下提供 K3 等級的品質,重點放在「同樣的錢換到更多任務量」。對需要控制推理成本的團隊,這個定位比跑分更有意義。
Fireworks Ember-1 的限制與注意事項
幾個要留意的點,先說在前面。
第一,它是 Kimi K3 的特化版本,不是通用最強模型。在需要極高通用推理或特定領域知識的任務上,它未必是最佳解,選擇還是要看你的實際工作性質。
第二,目前是 Research Preview,功能與表現都可能變動。拿它跑正式生產環境前,建議先在自己的任務上做 A/B 測試,看詞元用量與結果品質是否真的改善,而不是只看官方 benchmark。
第三,省的是推理詞元,不是解決所有成本問題。如果你的花費主要來自輸入長度或輸出長度,而非推理,省下來的那一塊對整體帳單的影響自然較小。
第四,用之前先確認資料處理條款。Fireworks 表示訓練未使用客戶資料,但你自己的敏感資料如何處理,仍要依訂閱方案與使用條款判斷。把內部程式碼或客戶資料丟進去之前,先搞清楚隱私與安全邊界,這條線不能鬆。
結論
Fireworks Ember-1 解決的是一個很具體的痛點:推理模型話太多,長會話越跑越貴。它用 Kimi K3 為底重新訓練,把不必要的推理剪掉,官方數據顯示能省 35% 到 50% 的推理詞元而品質持平,9 月 27 日起在 Fireworks serverless 上以 Research Preview 形式提供。
值不值得用,取決於你的工作是不是長會話、高快取那一路。是的話,值得排一輪實測;不是的話,先觀望也不吃虧。接下來值得觀察的是第三方獨立評測的結果,以及這款特化模型在正式版後會怎麼調,這兩點比官方數字更能決定它能不能長期站得住。
 NEWS
 REVIEWS
 HOWTO